Kafka là gì? Kiến trúc, cách hoạt động và khi nào nên dùng Apache Kafka
Trong bối cảnh dữ liệu lớn và phân tích thời gian thực ngày càng trở nên phổ biến, các tổ chức phải đối mặt với thách thức trong việc quản lý hiệu quả khối lượng thông tin khổng lồ đến từ nhiều nguồn khác nhau. Apache Kafka, một nền tảng streaming phân tán, đã trở thành một giải pháp mang tính đột phá cho việc truyền tải dữ liệu và xử lý thời gian thực.
Bài viết này Bizfly Cloud sẽ trình bày các đặc điểm và lợi ích cốt lõi của Apache Kafka, phân tích kiến trúc hệ thống, đồng thời minh họa các ứng dụng đa dạng của Kafka trong nhiều lĩnh vực và ngành nghề khác nhau.
Kafka là gì?
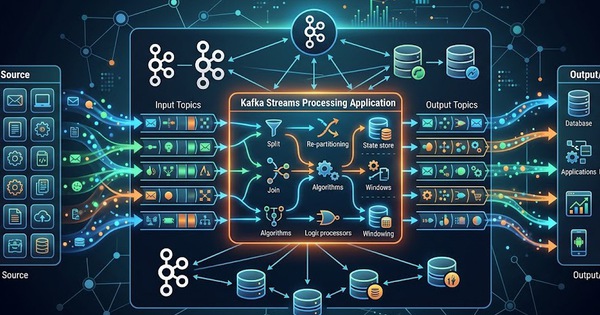
Kafka, hay Apache Kafka, là một nền tảng event streaming phân tán mã nguồn mở, được thiết kế để truyền, lưu trữ và xử lý luồng dữ liệu realtime với khả năng mở rộng cao. Có thể hiểu Kafka như một lớp trung gian tiếp nhận dữ liệu từ nhiều nguồn, lưu dữ liệu đó theo từng luồng sự kiện, sau đó phân phối cho nhiều hệ thống khác cùng xử lý.
Điểm quan trọng là Kafka không chỉ chuyển tiếp message rồi xóa ngay. Kafka lưu dữ liệu theo dạng log và cho phép consumer đọc lại dữ liệu từ một thời điểm trước đó nếu cần. Đây là lý do Kafka thường được dùng trong các hệ thống cần phân tích dữ liệu realtime, đồng bộ microservices, xử lý log tập trung hoặc xây dựng data pipeline.
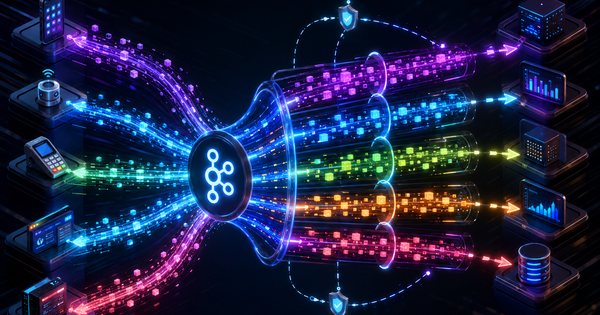
Ví dụ trong một sàn thương mại điệ n tử, khi người dùng đặt hàng, hệ thống có thể tạo ra sự kiện order_created. Sự kiện này không chỉ cần gửi cho hệ thống xử lý đơn hàng, mà còn có thể được dùng bởi hệ thống gửi thông báo, cập nhật tồn kho, chống gian lận, phân tích hành vi người dùng và báo cáo doanh thu. Nếu các hệ thống gọi trực tiếp lẫn nhau, kiến trúc sẽ nhanh chóng trở nên khó mở rộng và dễ lỗi dây chuyền. Kafka giúp tách các hệ thống này ra bằng cách để producer ghi sự kiện vào Kafka, còn consumer đọc sự kiện khi cần.

Kafka đóng vai trò trung gian giúp nhiều hệ thống trao đổi dữ liệu ổn định hơn
>> Xem thêm:
- Các thuật ngữ trong Kafka được sử dụng phổ biến
Kafka giải quyết bài toán gì
Kafka giải quyết bài toán truyền dữ liệu giữa nhiều hệ thống với tốc độ cao, độ tin cậy tốt và khả năng mở rộng theo chiều ngang. Khi hệ thống còn nhỏ, một ứng dụng có thể gọi API trực tiếp sang ứng dụng khác. Nhưng khi số lượng service tăng lên, lượng dữ liệu lớn hơn và yêu cầu realtime cao hơn, cách kết nối trực tiếp bắt đầu tạo ra nhiều điểm nghẽn.
- Thu thập log từ nhiều server để đưa về hệ thống phân tích tập trung
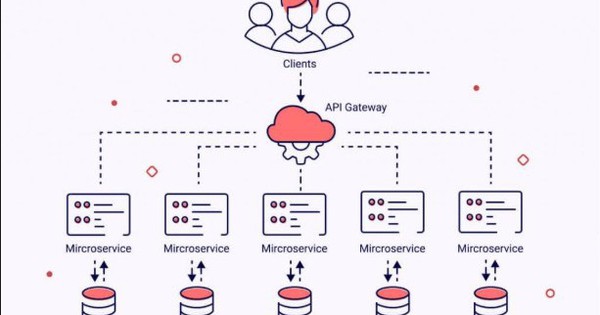
- Đồng bộ dữ liệu giữa các microservices mà không làm các service phụ thuộc chặt vào nhau
- Xử lý sự kiện realtime như clickstream, đơn hàng, giao dịch, thông báo hoặc dữ liệu cảm biến
- Xây dựng data pipeline đưa dữ liệu từ ứng dụng vào data warehouse, data lake hoặc hệ thống AI và ML
- Cho phép nhiều consumer cùng đọc một dòng dữ liệu cho nhiều mục đích khác nhau
Trong một hệ thống thanh toán, một giao dịch thành công có thể cần được nhiều hệ thống xử lý cùng lúc. Hệ thống đơn hàng cập nhật trạng thái, hệ thống email gửi hóa đơn, hệ thống chống gian lận ghi nhận rủi ro, hệ thống BI cập nhật báo cáo và hệ thống chăm sóc khách hàng lưu lịch sử giao dịch. Kafka giúp các hệ thống này đọc cùng một nguồn sự kiện mà không cần gọi chồng chéo lẫn nhau.

Kafka giúp giảm kết nối trực tiếp giữa các ứng dụng trong hệ thống doanh nghiệp
Kafka hoạt động như thế nào?
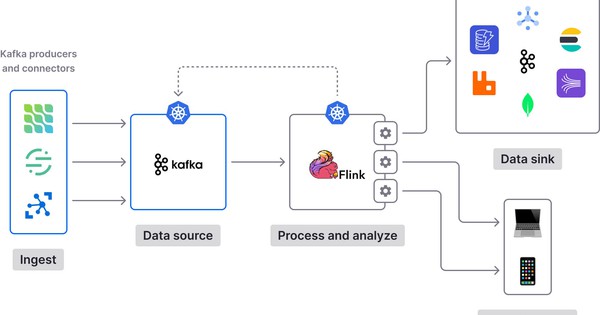
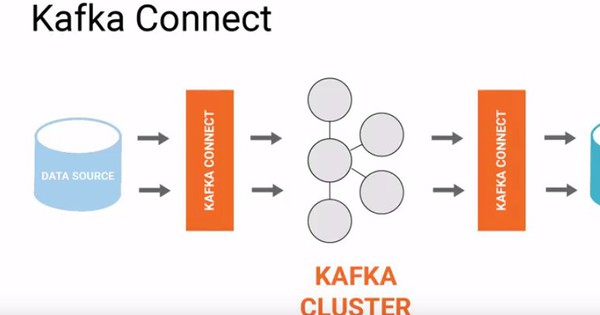
Kafka hoạt động theo mô hình ghi và đọc sự kiện qua topic. Producer ghi record vào topic, Kafka lưu record trong partition, còn consumer đọc record theo offset để xử lý.
Một luồng cơ bản thường diễn ra như sau:
- Producer tạo ra một record, ví dụ user_logged_in hoặc payment_success
- Producer gửi record vào một topic trong Kafka
- Kafka ghi record vào một partition của topic
- Broker lưu record trên disk theo dạng log tuần tự
- Consumer đọc record từ topic theo offset
- Consumer xử lý dữ liệu theo mục đích riêng
- Kafka giữ record theo chính sách retention để consumer có thể đọc lại khi cần
Điểm đáng chú ý là producer và consumer không cần phụ thuộc trực tiếp vào nhau. Producer chỉ cần gửi dữ liệu vào Kafka. Consumer có thể đọc nhanh, đọc chậm, đọc lại hoặc có thêm consumer mới mà không ảnh hưởng đến producer.
>> Xem thêm: Hướng dẫn chi tiết cách cài đặt Apache Kafka từ A-Z

Luồng dữ liệu cơ bản từ producer đến Kafka và consumer
Kiến trúc Kafka gồm những thành phần nào
Để hiểu Kafka, cần nắm một số thành phần cốt lõi: Producer, consumer, broker, topic, partition, offset, consumer group và controller. Các thành phần này phối hợp với nhau để Kafka có thể xử lý dữ liệu theo luồng, phân tán tải và đảm bảo khả năng mở rộng.
Producer
Producer là nơi tạo và gửi dữ liệu vào Kafka. Trong thực tế, producer có thể là ứng dụng web, app mobile, service đơn hàng, hệ thống thanh toán, log server, thiết bị IoT hoặc bất kỳ hệ thống nào phát sinh dữ liệu cần xử lý.
Producer không cần biết chính xác có bao nhiêu hệ thống phía sau đang đọc dữ liệu. Nó chỉ cần gửi event vào đúng topic trong Kafka.
Topic
Topic là nơi Kafka phân loại dữ liệu theo từng chủ đề. Có thể hiểu topic như một dòng sự kiện riêng biệt. Ví dụ, một hệ thống thương mại điện tử có thể có các topic như user_registered, order_created, payment_success, order_cancelled.
Việc thiết kế topic rất quan trọng vì nó ảnh hưởng đến cách dữ liệu được tổ chức, đọc lại và mở rộng sau này. Một topic quá chung có thể gây khó xử lý, trong khi quá nhiều topic nhỏ có thể làm hệ thống khó quản lý.
Partition
Partition là cách Kafka chia nhỏ một topic để tăng khả năng xử lý song song. Một topic có thể có nhiều partition, và mỗi partition là một log có thứ tự.
Ví dụ, topic order_events có 6 partition. Khi lượng đơn hàng tăng, Kafka có thể phân phối dữ liệu vào nhiều partition để nhiều consumer xử lý song song. Đây là một trong những lý do Kafka có khả năng mở rộng tốt.
Tuy nhiên, thứ tự message chỉ được đảm bảo trong phạm vi một partition, không phải trên toàn bộ topic. Vì vậy, khi thiết kế partition key, cần xác định rõ loại dữ liệu nào cần giữ thứ tự. Ví dụ, nếu muốn giữ đúng thứ tự sự kiện của từng đơn hàng, có thể dùng order_id làm key.
Broker
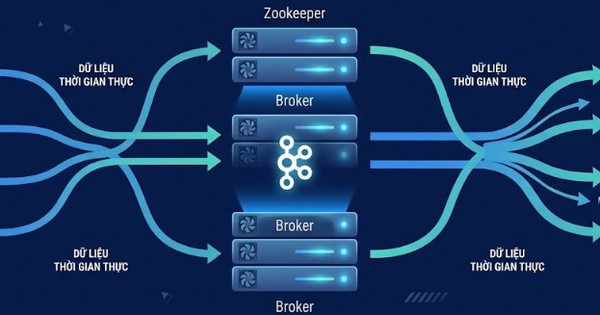
Broker là máy chủ Kafka chịu trách nhiệm lưu trữ dữ liệu và phục vụ yêu cầu đọc/ghi. Một Kafka cluster thường có nhiều broker để phân tán tải và tăng khả năng chịu lỗi.
Khi dữ liệu được replication giữa nhiều broker, hệ thống có thể tiếp tục hoạt động ngay cả khi một broker gặp sự cố, miễn là cụm Kafka được cấu hình đúng.
Consumer
Consumer là hệ thống đọc dữ liệu từ Kafka để xử lý. Ví dụ, sau khi topic order_created nhận được sự kiện đơn hàng mới, hệ thống kho có thể đọc để trừ tồn, hệ thống email đọc để gửi xác nhận, còn data warehouse đọc để cập nhật báo cáo.
Consumer có thể đọc dữ liệu theo tốc độ riêng. Nếu consumer bị chậm tạm thời, dữ liệu vẫn có thể được giữ trong Kafka theo chính sách retention để xử lý tiếp sau đó.
Consumer group
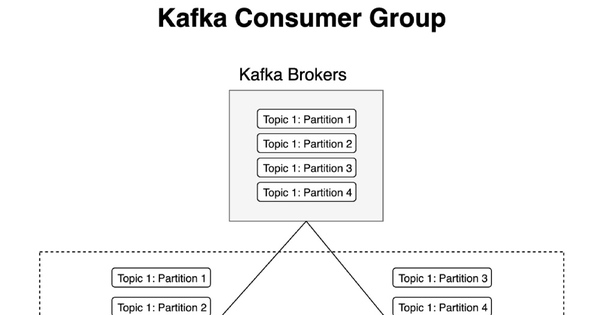
Consumer group cho phép nhiều consumer cùng chia nhau xử lý dữ liệu trong một topic. Đây là cơ chế quan trọng giúp Kafka mở rộng khả năng xử lý.
Ví dụ, nếu một topic có lượng dữ liệu rất lớn, doanh nghiệp có thể tăng số consumer trong cùng một consumer group để xử lý song song. Cơ chế này phù hợp với các hệ thống có lưu lượng cao như giao dịch tài chính, log hệ thống, hành vi người dùng hoặc dữ liệu clickstream.

Consumer group cho phép nhiều consumer cùng xử lý dữ liệu hiệu quả hơn
Offset
Offset là vị trí của một bản ghi trong partition. Consumer dùng offset để biết mình đã đọc đến đâu. Nhờ offset, consumer có thể tạm dừng rồi đọc tiếp, hoặc đọc lại dữ liệu cũ khi cần xử lý lại.
Đây là một trong những lý do Kafka phù hợp với data pipeline và stream processing. Dữ liệu không nhất thiết biến mất ngay sau khi được đọc, mà có thể được giữ lại để phục vụ nhiều nhu cầu khác nhau.
Controller và KRaft
Controller chịu trách nhiệm quản lý metadata của Kafka cluster, chẳng hạn broker nào đang hoạt động, partition nào nằm trên broker nào, leader partition là broker nào.
Trước đây, Kafka thường sử dụng ZooKeeper để quản lý metadata cluster. Tuy nhiên, từ Kafka 4.0, ZooKeeper mode đã bị loại bỏ và Kafka chỉ hỗ trợ KRaft mode.
KRaft, viết tắt từ Kafka Raft Metadata mode, giúp Kafka tự quản lý metadata bằng cơ chế Raft quorum mà không cần phụ thuộc vào ZooKeeper. Điều này giúp kiến trúc Kafka gọn hơn, giảm một lớp vận hành và phù hợp hơn với các hệ thống Kafka hiện đại.
Kafka khác gì message queue truyền thống?
Kafka có thể đảm nhiệm một số vai trò giống message queue, nhưng bản chất của Kafka rộng hơn. Message queue truyền thống thường tập trung vào việc chuyển message từ producer đến consumer để xử lý tác vụ. Kafka tập trung vào việc lưu trữ và phân phối dòng sự kiện, cho phép nhiều consumer đọc cùng một dữ liệu và có thể đọc lại khi cần.
Tiêu chí | Message queue truyền thống | Kafka |
Mục tiêu chính | Gửi message để xử lý tác vụ | Ghi, lưu trữ và phân phối event stream |
Lưu message sau khi đọc | Thường xóa hoặc đánh dấu đã xử lý | Có thể giữ theo retention |
Đọc lại dữ liệu | Hạn chế hơn | Hỗ trợ đọc lại theo offset |
Mở rộng xử lý | Có, tùy hệ thống | Mạnh nhờ partition và consumer group |
Nhiều hệ thống cùng đọc | Có thể phức tạp | Là use case tự nhiên |
Phù hợp với | Task queue, routing phức tạp, job nền | Realtime data, log, event driven, data pipeline |
So sánh Kafka với RabbitMQ, Redis, Spark và Kinesis
Kafka thường được so sánh với RabbitMQ, Redis Pub/Sub, Spark hoặc Kinesis. Tuy nhiên, các công nghệ này không hoàn toàn thay thế nhau. Mỗi công nghệ được thiết kế cho một nhóm bài toán khác nhau.
Công nghệ | Bản chất | Khi nên dùng |
Kafka | Distributed event streaming platform | Data pipeline, log streaming, microservices, realtime analytics |
RabbitMQ | Message broker truyền thống | Task queue, workflow, message cần routing phức tạp |
Redis Pub/Sub | Cơ chế publish subscribe tốc độ cao | Thông báo realtime đơn giản, dữ liệu không cần lưu lâu |
Spark | Engine xử lý dữ liệu | ETL, analytics, machine learning pipeline |
Kinesis | Dịch vụ streaming managed trên AWS | Doanh nghiệp chạy chủ yếu trong hệ sinh thái AWS |
>> Có thể bạn quan tâm:
Khi nào nên dùng Kafka?
Kafka phù hợp khi hệ thống có nhiều dữ liệu phát sinh liên tục và cần xử lý theo thời gian gần thực. Kafka đặc biệt hữu ích khi nhiều ứng dụng cần dùng chung một luồng dữ liệu nhưng xử lý theo mục đích khác nhau.
- Hệ thống microservices cần trao đổi dữ liệu bất đồng bộ.
- Website hoặc ứng dụng có lượng event lớn như click, view, search, add to cart hoặc checkout.
- Hệ thống cần xử lý log tập trung từ nhiều server.
- Doanh nghiệp cần pipeline đưa dữ liệu vào data warehouse, data lake hoặc hệ thống phân tích.
- Hệ thống tài chính, thương mại điện tử, logistics, media hoặc IoT cần xử lý sự kiện realtime.
- Cần khả năng đọc lại dữ liệu để tái xử lý, audit hoặc phục hồi pipeline.

Apache Kafka đóng vai trò là xương sống dữ liệu thời gian thực
Khi nào không nên dùng Kafka?
Kafka mạnh, nhưng không phải hệ thống nào cũng cần Kafka. Nếu triển khai khi bài toán chưa đủ lớn, Kafka có thể làm kiến trúc phức tạp hơn mức cần thiết.
- Ứng dụng nhỏ, lượng message thấp và chỉ cần xử lý vài job nền đơn giản.
- Team chưa có kinh nghiệm vận hành distributed system.
- Dữ liệu không cần realtime hoặc không cần nhiều consumer cùng đọc.
- Bài toán chỉ cần request response trực tiếp qua API.
- Không có yêu cầu lưu lại event để đọc lại.
- Hạ tầng chưa sẵn sàng cho monitoring, alerting, backup, security và capacity planning.
Triển khai Kafka production cần chú ý gì?
Triển khai Kafka trong môi trường production cần nhiều hơn việc cài đặt broker và tạo topic. Để Kafka ổn định, đội kỹ thuật cần quan tâm đến thiết kế partition, replication, retention, monitoring, bảo mật và khả năng mở rộng.
- Số lượng broker cần đủ để phân tán partition và đảm bảo khả năng chịu lỗi.
- Replication factor nên được cấu hình để giảm rủi ro mất dữ liệu khi broker gặp sự cố.
- Partition key cần được chọn đúng để giữ thứ tự cần thiết và tránh lệch tải.
- Retention policy cần xác định dữ liệu được giữ trong bao lâu, theo thời gian hay dung lượng.
- Consumer lag cần được theo dõi để biết consumer có xử lý kịp tốc độ dữ liệu ghi vào hay không.
- Security cần bao gồm xác thực, phân quyền, mã hóa và kiểm soát truy cập client.
- Upgrade cần có kế hoạch rõ ràng, nhất là với hệ thống chuyển từ ZooKeeper sang KRaft.
Tự triển khai Kafka hay dùng Managed Kafka?
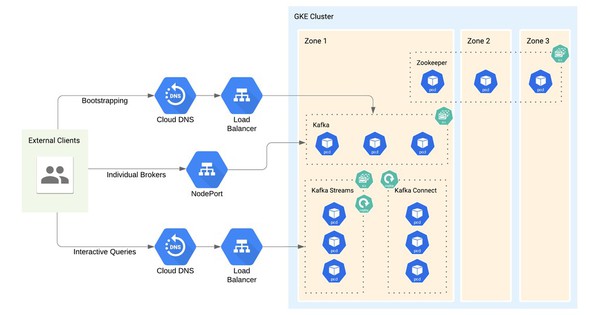
Doanh nghiệp có thể tự triển khai Kafka trên server, Kubernetes hoặc cloud infrastructure. Cách này phù hợp với đội kỹ thuật có kinh nghiệm vận hành hệ thống phân tán, có khả năng xử lý monitoring, backup, scaling, security và upgrade.
Tuy nhiên, tự vận hành Kafka cũng đi kèm nhiều việc cần kiểm soát như cấu hình broker, quản lý storage, theo dõi consumer lag, xử lý sự cố broker, mở rộng cluster, nâng cấp phiên bản và bảo mật kết nối client.
Với doanh nghiệp muốn dùng Kafka cho data pipeline, microservices, log streaming hoặc xử lý realtime nhưng không muốn dành quá nhiều nguồn lực cho vận hành hạ tầng, Managed Kafka là hướng đáng cân nhắc. Có thể tham khảo Bizfly Cloud Kafka để rút ngắn thời gian khởi tạo cụm Kafka và giảm tải phần vận hành cho đội kỹ thuật.

Bizfly Kafka hỗ trợ triển khai và vận hành Kafka trên hạ tầng Bizfly Cloud
FAQ về Kafka
Kafka có phù hợp cho hệ thống nhỏ không?
Không phải lúc nào cũng phù hợp. Nếu hệ thống chỉ có vài tác vụ nền đơn giản, lượng dữ liệu thấp và không cần nhiều consumer đọc cùng một dòng event, Kafka có thể làm kiến trúc phức tạp hơn cần thiết.
Kafka có xử lý dữ liệu realtime tuyệt đối không?
Kafka thường được dùng cho xử lý gần thời gian thực. Độ trễ thực tế còn phụ thuộc vào cấu hình producer, broker, consumer, network, kích thước message và hệ thống xử lý phía sau.
Kafka lưu dữ liệu trong bao lâu?
Kafka lưu dữ liệu theo chính sách retention, có thể dựa trên thời gian hoặc dung lượng. Trong thời hạn dữ liệu còn được giữ lại, consumer có thể đọc lại hoặc xử lý lại dữ liệu.
Kafka có khó vận hành không?
Có. Kafka yêu cầu hiểu về broker, topic, partition, replication, offset, consumer lag, retention, monitoring và bảo mật. Vì vậy, với môi trường production, doanh nghiệp cần đội ngũ vận hành có kinh nghiệm hoặc cân nhắc Managed Kafka.
Kết luận
Kafka là nền tảng event streaming mạnh cho các hệ thống cần xử lý dữ liệu realtime, mở rộng theo chiều ngang và tách rời producer với consumer. Điểm khác biệt lớn của Kafka nằm ở khả năng lưu trữ event theo log, chia dữ liệu bằng partition, cho phép nhiều consumer cùng đọc và hỗ trợ đọc lại dữ liệu khi cần.
Với các doanh nghiệp đang xây dựng microservices, data pipeline, hệ thống log tập trung hoặc nền tảng phân tích realtime, Kafka là một thành phần hạ tầng rất đáng cân nhắc. Tuy nhiên, Kafka cũng đòi hỏi năng lực vận hành tốt. Nếu doanh nghiệp muốn tận dụng Kafka nhưng giảm gánh nặng triển khai, giám sát và mở rộng cluster, các dịch vụ Managed Kafka như Bizfly Cloud Kafka có thể là lựa chọn phù hợp để bắt đầu nhanh và vận hành ổn định hơn.