Kafka Python: Chọn thư viện đúng và triển khai đúng cách
Khi dùng Kafka với Python, vấn đề không chỉ là “cài thư viện nào để gửi và nhận message”. Câu hỏi quan trọng hơn là hệ thống của bạn cần xử lý bao nhiêu dữ liệu, có yêu cầu độ trễ thấp không, dữ liệu có cần schema rõ ràng không và team có đủ kinh nghiệm để vận hành consumer, offset, retry hay dead-letter queue hay chưa.
Nếu chọn thư viện quá đơn giản cho hệ thống production, bạn có thể gặp lỗi về hiệu năng, duplicate message, mất dữ liệu hoặc khó debug khi consumer bị chậm. Ngược lại, nếu dùng thư viện quá phức tạp cho một prototype nhỏ, đội phát triển lại mất thời gian cho cấu hình thay vì kiểm chứng bài toán.
Bài viết dưới đây Bizfly Cloud đi từ cách chọn thư viện Kafka Python phù hợp đến những nguyên tắc triển khai Producer, Consumer và chuẩn hóa message để hệ thống dễ mở rộng hơn về sau.
Kafka Python là gì?
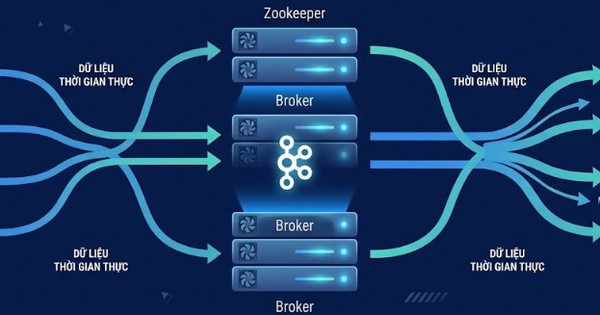
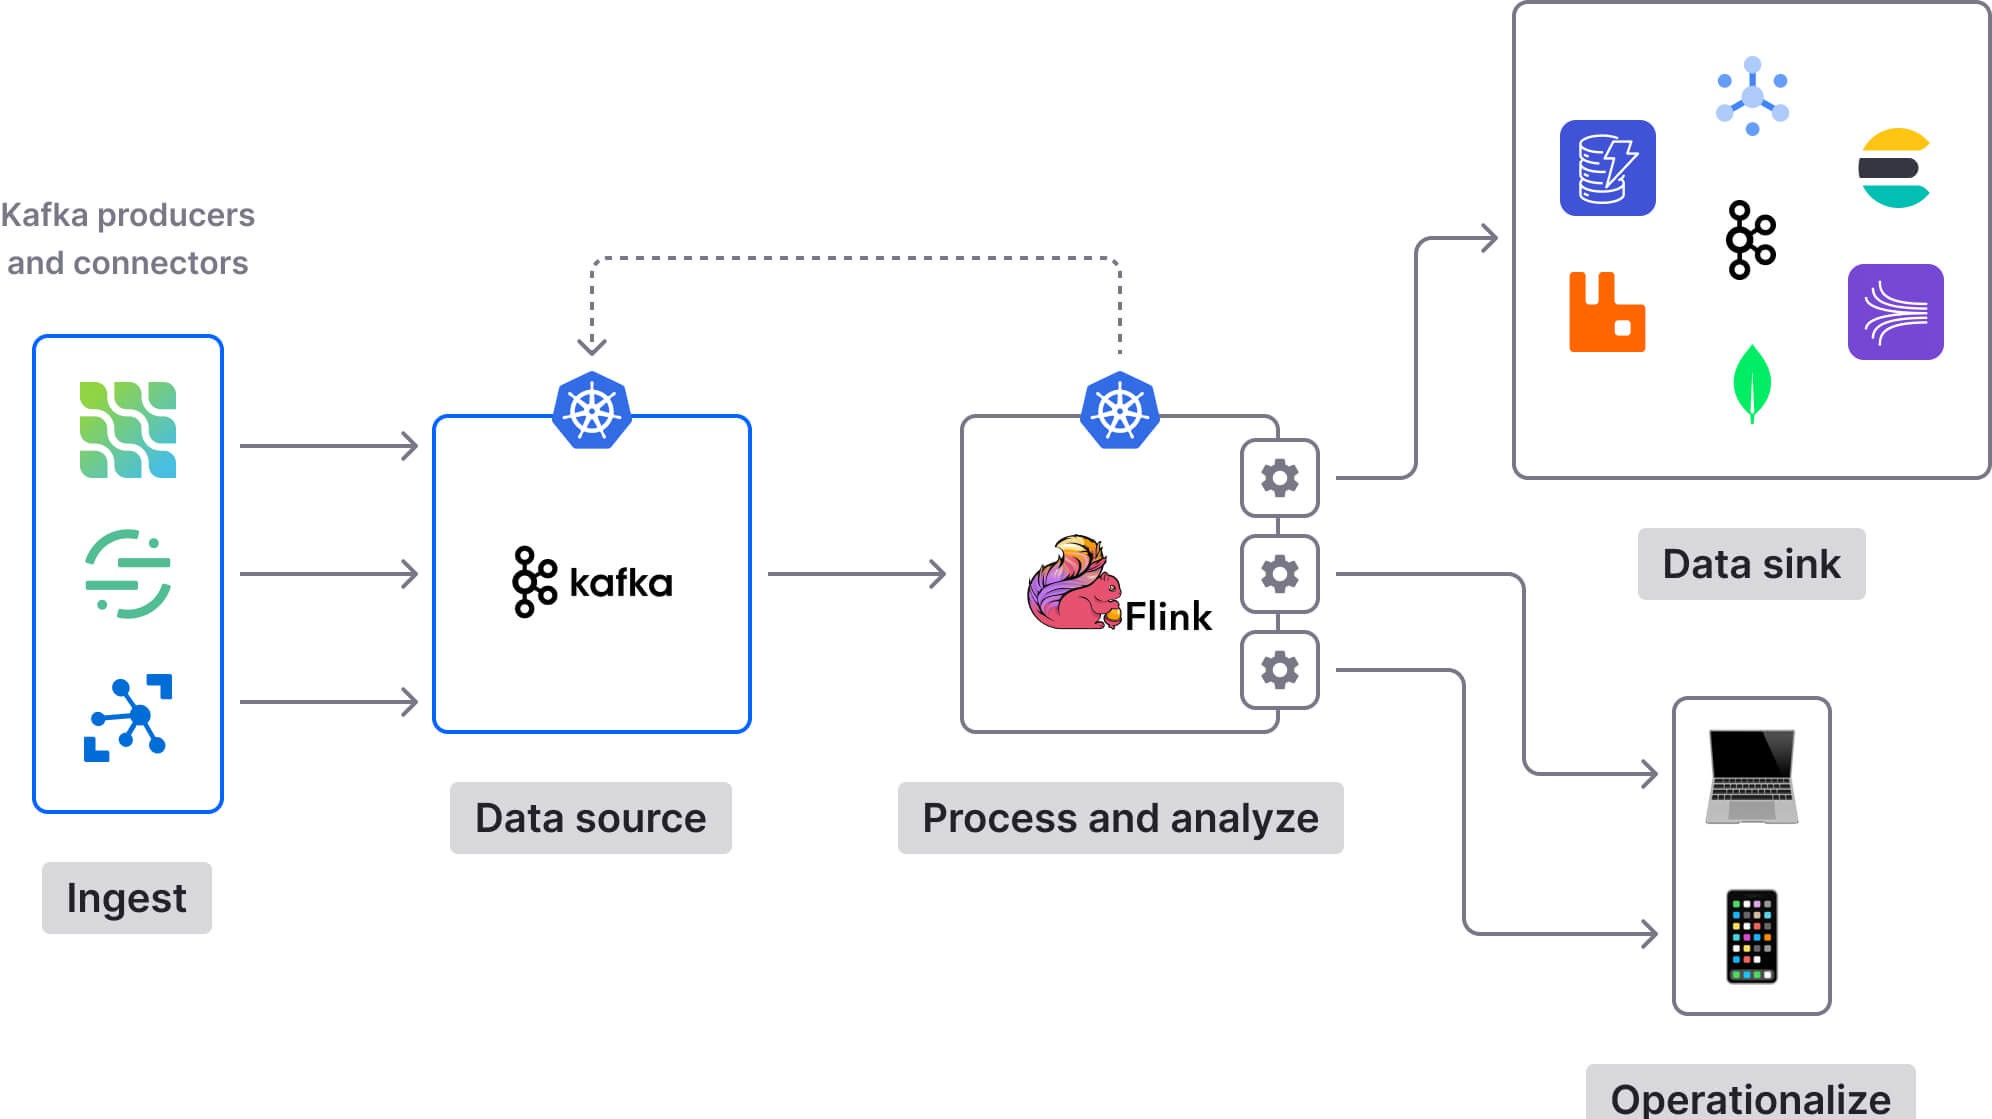
Kafka Python thường được hiểu là cách các ứng dụng viết bằng Python kết nối với Apache Kafka để gửi, nhận và xử lý dữ liệu theo thời gian thực. Trong mô hình này, Python application có thể đóng vai trò là Producer, Consumer hoặc một service xử lý dữ liệu nằm giữa nhiều hệ thống khác nhau.
Ví dụ, một hệ thống thương mại điện tử có thể dùng Python để gửi sự kiện “đơn hàng mới” vào Kafka. Sau đó, các consumer khác nhau sẽ đọc sự kiện này để cập nhật kho, gửi email xác nhận, ghi log phân tích hoặc đồng bộ dữ liệu sang dashboard vận hành.
Điểm cần hiểu ngay từ đầu chính là Kafka không tự biến Python thành một nền tảng stream processing hoàn chỉnh. Thư viện Kafka Python chỉ là phần kết nối giữa ứng dụng Python và Kafka broker. Hệ thống có ổn định hay không còn phụ thuộc vào cách bạn thiết kế topic, partition key, consumer group, schema, retry và cách xử lý lỗi.

Việc lựa chọn thư viện Kafka cho Python phụ thuộc vào nhu cầu về hiệu năng và sự đơn giản
Khi nào nên dùng Kafka với Python?
Kafka phù hợp khi ứng dụng Python cần làm việc với dữ liệu phát sinh liên tục, nhiều nguồn và cần xử lý gần thời gian thực. Nếu chỉ có một tác vụ nhỏ, chạy theo lịch mỗi vài giờ, Kafka có thể là lựa chọn quá nặng. Nhưng nếu dữ liệu cần được nhiều hệ thống tiêu thụ cùng lúc, Kafka sẽ giúp tách rời các service và giảm phụ thuộc trực tiếp giữa chúng.
Một số tình huống nên dùng Kafka Python:
- Gửi log, event hoặc clickstream từ backend Python sang hệ thống phân tích
- Xử lý dữ liệu IoT, giao dịch, hành vi người dùng hoặc dữ liệu giám sát theo thời gian thực
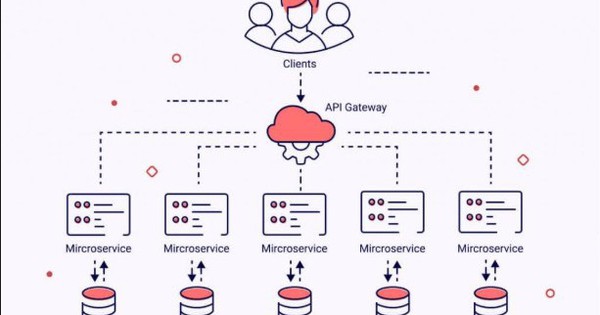
- Đồng bộ dữ liệu giữa microservices mà không muốn các service gọi trực tiếp lẫn nhau
- Xây dựng pipeline ETL/ELT, trong đó Python đảm nhiệm bước làm sạch, enrich hoặc chuyển đổi dữ liệu
- Tích hợp AI/ML pipeline, ví dụ đưa dữ liệu mới vào model scoring hoặc feature store
Không nên dùng Kafka chỉ vì “hệ thống lớn nghe có vẻ cần Kafka”. Nếu bài toán chỉ là gửi vài thông báo đơn giản, queue truyền thống hoặc database job có thể dễ vận hành hơn.
3 thư viện Kafka Python phổ biến và nên chọn trường hợp nào
Confluent-kafka
Confluent Kafka Python là wrapper nhẹ xung quanh librdkafka - thư viện C/C++ nổi tiếng, đã có một cộng đồng lớn và ổn định. Thư viện này cung cấp các lớp Producer, Consumer, AdminClient và tích hợp sâu các tính năng của Confluent Platform như Schema Registry, giúp nâng cao khả năng kiểm soát, an toàn dữ liệu, tối ưu hiệu suất.
Điểm mạnh của Confluent Kafka Python nằm ở khả năng xử lý hiệu quả, phù hợp với các hệ thống yêu cầu độ trễ thấp, dung lượng lớn và có tính mở rộng cao. Tuy nhiên, code của thư viện này thường nhiều hơn, cần cấu hình phức tạp và xử lý lỗi kỹ lưỡng hơn so với các thư viện thuần Python. Phù hợp cho các dự án doanh nghiệp hoặc các hệ thống sản xuất đòi hỏi độ ổn định cao.

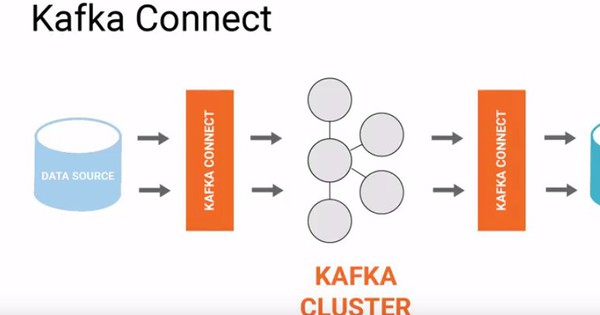
Confluent Kafka là phiên bản thương mại, nâng cao của Apache Kafka
Kafka-python
Dù ra đời đã lâu và ít cập nhật hơn so với các thư viện mới, kafka-python vẫn giữ vững vị trí là thư viện Kafka Python phổ biến vì tính đơn giản, dễ hiểu, sở hữu tính tương thích cao. Thư viện này được viết hoàn toàn bằng Python, không cần cài đặt thêm thư viện phụ trợ, phù hợp với các dự án nhỏ, dự án cá nhân hay các quick-start nhanh.
Với kafka-python, bạn có thể dễ dàng thiết lập producer, consumer để gửi nhận message, quản lý topic, làm việc đồng bộ hoặc bất đồng bộ mà không quá rườm rà. Tuy nhiên, do viết bằng Python thuần, hiệu suất có thể thấp hơn một chút so với Confluent Kafka Python hoặc Quix Streams.
Quix Streams
Quix Streams là một thư viện mã nguồn mở chạy trên nền tảng đám mây, mang sức mạnh của hệ thống phân tán nhưng gói gọn lại trong một thư viện nhẹ, dễ dùng. Nhờ đó, bạn có thể xây dựng và xử lý pipeline dữ liệu real-time mà không cần quá nhiều thiết lập phức tạp nhưng vẫn giữ được hiệu năng và độ ổn định cần thiết.
Điểm nổi bật của Quix Streams là khả năng chuyển đổi dữ liệu sang dạng Streaming DataFrame. Nhà phát triển có thể dễ dàng thực hiện các phân tích, trực quan dữ liệu do đó phù hợp với các dự án công nghiệp, hệ thống xử lý stream phức tạp.
Nên chọn thư viện Kafka Python nào?
Hiện nay, ba lựa chọn thường được nhắc đến là confluent-kafka, kafka-python và quixstreams. Mỗi thư viện giải quyết một kiểu nhu cầu khác nhau, vì vậy không nên chọn theo mức độ phổ biến chung chung.
| Thư viện | Phù hợp nhất với | Điểm mạnh | Điểm cần cân nhắc |
|---|---|---|---|
confluent-kafka | Hệ thống production, cần hiệu năng và độ ổn định cao | Dựa trên librdkafka, có Producer, Consumer, AdminClient và hỗ trợ Schema Registry | Cấu hình nhiều hơn, cần hiểu rõ callback, poll, commit và xử lý lỗi |
kafka-python | Học Kafka, demo, prototype, dự án nhỏ | Thuần Python, dễ cài, dễ đọc code, dễ bắt đầu | Hiệu năng và mức độ phù hợp production thường không bằng confluent-kafka |
quixstreams | Stream processing bằng Python, xử lý dữ liệu theo pipeline | Có API dạng Streaming DataFrame, gần với tư duy xử lý dữ liệu của Python/Pandas | Phù hợp hơn khi cần xử lý stream, không chỉ gửi/nhận message đơn giản |
Cách chọn nhanh theo từng tình huống
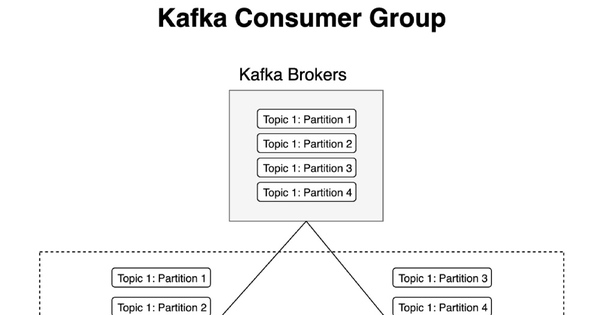
Nếu bạn chỉ cần học Kafka hoặc viết thử Producer/Consumer trong vài giờ, hãy bắt đầu với kafka-python. Cú pháp dễ hiểu, ít phụ thuộc và đủ để nắm các khái niệm cơ bản như topic, message, consumer group và offset.
Nếu bạn đang làm hệ thống backend thật, có traffic ổn định, cần retry, monitoring, commit offset rõ ràng và schema nghiêm túc, nên chọn confluent-kafka. Đây là lựa chọn thực tế hơn cho production vì hiệu năng tốt và bám sát hệ sinh thái Kafka.
Nếu team của bạn làm data engineering, xử lý chuỗi biến đổi dữ liệu hoặc muốn viết logic stream theo phong cách Python data stack, hãy cân nhắc quixstreams. Thư viện này hợp với bài toán biến đổi dữ liệu real-time hơn là chỉ gửi và nhận message đơn thuần.
Một cách chọn ngắn gọn:
- Học và demo:
kafka-python - Backend production:
confluent-kafka - Data pipeline real-time:
quixstreams - Cần Schema Registry: ưu tiên
confluent-kafka - Cần code giống Pandas để xử lý stream: cân nhắc
quixstreams
Chuẩn bị môi trường test nhanh để triển khai đúng
Đừng bắt đầu bằng cách cắm thẳng code Python vào Kafka production. Một môi trường test nhỏ giúp bạn kiểm tra ba việc quan trọng: kết nối broker có ổn không, message có đúng định dạng không và consumer có đọc đúng như kỳ vọng không.
Môi trường tối thiểu nên có:
- Python 3.x
- Kafka broker để test, có thể chạy bằng Docker hoặc dùng cụm Kafka nội bộ
- Một topic riêng để thử nghiệm, ví dụ
python-events-test - Một Producer gửi dữ liệu mẫu
- Một Consumer đọc dữ liệu và log lại kết quả
- Công cụ quan sát topic, consumer group và lag nếu có
Với dự án thật, nên tạo môi trường staging gần giống production. Nhiều lỗi Kafka Python không xuất hiện khi gửi vài message test, nhưng sẽ lộ ra khi dữ liệu tăng, consumer restart hoặc broker tạm thời mất kết nối.
Triển khai Producer trong Python sao cho đúng
Producer không chỉ có nhiệm vụ “đẩy message vào Kafka”. Producer phải đảm bảo message được gửi đúng topic, đúng key, đúng định dạng và có cơ chế biết message đã gửi thành công hay thất bại.
Một Producer cơ bản cần chú ý các điểm sau:
- Chọn
keyhợp lý để Kafka phân bổ message vào partition đúng cách - Dùng
valuetheo định dạng thống nhất, thường là JSON, Avro hoặc Protobuf - Có callback để biết message gửi thành công hay lỗi
- Flush dữ liệu trước khi ứng dụng dừng. Log lỗi đủ rõ để truy vết topic, key và nguyên nhân thất bại
Ví dụ với confluent-kafka:
import json
from confluent_kafka import Producer
producer = Producer({
"bootstrap.servers": "localhost:9092",
"acks": "all",
"retries": 3,
"linger.ms": 10,
})
def delivery_report(err, msg):
if err is not None:
print(f"Send failed: {err}")
return
print(
f"Message delivered to {msg.topic()} "
f"[partition {msg.partition()}] at offset {msg.offset()}"
)
event = {
"order_id": "ORD-1001",
"customer_id": "CUS-88",
"amount": 590000,
"status": "created",
}
producer.produce(
topic="orders",
key=event["order_id"],
value=json.dumps(event).encode("utf-8"),
callback=delivery_report,
)
producer.poll(0)
producer.flush()
Trong production, không nên gửi message mà không kiểm tra callback. Nếu Producer báo lỗi nhưng ứng dụng vẫn coi như thành công, dữ liệu có thể mất từ rất sớm trong pipeline.
>> Có thể bạn quan tâm: Cách triển khai Kafka Cluster production từ A-Z
Chọn key cho message: lỗi nhỏ nhưng ảnh hưởng lớn
Nhiều hệ thống Kafka bị sai từ bước chọn key. Nếu key được chọn ngẫu nhiên, dữ liệu có thể phân bổ đều nhưng mất thứ tự theo nghiệp vụ. Nếu key quá lệch, một vài partition sẽ bị quá tải trong khi partition khác gần như rảnh.
Ví dụ, với dữ liệu đơn hàng, order_id phù hợp nếu mỗi đơn hàng được xử lý độc lập. Nhưng nếu bạn cần đảm bảo toàn bộ sự kiện của một khách hàng đi theo đúng thứ tự, customer_id có thể hợp lý hơn.
Nguyên tắc đơn giản:
- Cần giữ thứ tự theo đơn hàng: dùng
order_id. - Cần giữ thứ tự theo khách hàng: dùng
customer_id. - Cần phân bổ đều và không quan tâm thứ tự nghiệp vụ: có thể để Kafka phân phối mặc định.
- Không dùng một key cố định cho toàn bộ message, vì sẽ dồn tải vào một partition.
Key không phải chi tiết kỹ thuật phụ. Nó quyết định cách Kafka chia tải, giữ thứ tự và ảnh hưởng trực tiếp đến khả năng mở rộng consumer về sau.
Triển khai Consumer trong Python: đừng chỉ đọc message rồi xử lý
Consumer là phần dễ gây lỗi hơn Producer, vì nó liên quan đến offset, retry, duplicate message và trạng thái xử lý thực tế. Một consumer viết vội có thể chạy ổn trong demo, nhưng khi restart hoặc gặp lỗi giữa chừng, hệ thống có thể xử lý trùng hoặc bỏ sót dữ liệu.
Một Consumer production nên có các nguyên tắc:
- Tắt auto commit nếu cần kiểm soát chính xác thời điểm commit offset.
- Chỉ commit sau khi xử lý message thành công.
- Có xử lý lỗi riêng cho lỗi tạm thời và lỗi dữ liệu sai.
- Có cơ chế dừng an toàn khi service shutdown.
- Theo dõi consumer lag để biết pipeline có bị chậm không.
Ví dụ đơn giản với confluent-kafka:
import jsonfrom confluent_kafka import Consumer, KafkaExceptionconsumer = Consumer({ "bootstrap.servers": "localhost:9092", "group.id": "order-worker", "auto.offset.reset": "earliest", "enable.auto.commit": False,})consumer.subscribe(["orders"])try: while True: msg = consumer.poll(1.0) if msg is None: continue if msg.error(): raise KafkaException(msg.error()) event = json.loads(msg.value().decode("utf-8")) # Process business logic here print(f"Processing order: {event['order_id']}") consumer.commit(msg)finally: consumer.close()
Điểm quan trọng nằm ở dòng consumer.commit(msg). Nếu commit trước khi xử lý xong, message có thể bị mất khi service lỗi. Nếu không commit hoặc commit sai thời điểm, message có thể bị xử lý lại nhiều lần.
Chuẩn hóa message trước khi hệ thống lớn lên
Ở giai đoạn đầu, nhiều team gửi JSON tự do vì nhanh. Cách này không sai, nhưng nếu không có quy ước rõ ràng, message sẽ rất nhanh trở thành “mỗi service hiểu một kiểu”. Khi thêm consumer mới, đổi field hoặc nâng version dữ liệu, lỗi sẽ xuất hiện liên tục.
Một message nên có cấu trúc tối thiểu:
{ "event_id": "evt_20260417_001", "event_type": "order.created", "event_version": 1, "occurred_at": "2026-04-17T12:15:19Z", "payload": { "order_id": "ORD-1001", "customer_id": "CUS-88", "amount": 590000 }}
Cấu trúc này giúp consumer biết đây là sự kiện gì, version nào, xảy ra lúc nào và dữ liệu nghiệp vụ nằm ở đâu. Khi hệ thống có nhiều team cùng sử dụng Kafka, nên dùng schema nghiêm túc hơn như Avro, Protobuf hoặc JSON Schema. Với confluent-kafka, Schema Registry có thể được tích hợp trực tiếp trong Python client để quản lý schema và serializer/deserializer.
Xử lý lỗi: retry, dead-letter topic và idempotency
Kafka không tự giải quyết toàn bộ lỗi nghiệp vụ cho bạn. Nếu consumer đọc được message nhưng gọi API bên ngoài thất bại, ghi database lỗi hoặc gặp dữ liệu sai định dạng, ứng dụng phải có chiến lược xử lý rõ ràng.
Có ba nhóm lỗi thường gặp:
| Loại lỗi | Ví dụ | Cách xử lý nên dùng |
|---|---|---|
| Lỗi tạm thời | API timeout, database quá tải, network chập chờn | Retry có giới hạn, backoff, không commit quá sớm |
| Lỗi dữ liệu | Thiếu field, sai schema, sai định dạng ngày | Đưa vào dead-letter topic để kiểm tra sau |
| Lỗi logic | Trạng thái đơn hàng không hợp lệ, dữ liệu trùng | Thiết kế idempotency, kiểm tra trước khi ghi |
Idempotency là điểm rất quan trọng. Trong Kafka, consumer có thể nhận lại message trong một số tình huống như restart, rebalance hoặc commit offset thất bại. Vì vậy, logic xử lý nên chịu được duplicate message. Ví dụ, khi ghi giao dịch vào database, hãy dùng event_id hoặc khóa nghiệp vụ để tránh ghi trùng.
7 lỗi thường gặp khi triển khai Kafka Python
Dưới đây là 7 lỗi phổ biến khi các nhà phát triển bắt đầu làm việc với Kafka Python:
- Lỗi cấu hình broker sai: Không đúng địa chỉ hoặc port dẫn đến kết nối thất bại hoặc không thể gửi nhận message.
- Thiếu hoặc sai schema: Gửi dữ liệu không tuân theo schema thống nhất gây lỗi hoặc mất dữ liệu.
- Xử lý ngoại lệ không phù hợp: Quên xử lý retries hoặc log lỗi dẫn đến mất message hoặc hệ thống dừng đột ngột.
- Chạy nhiều producer/consumer không đúng cách: Không quản lý concurrency hoặc không tắt đúng khi hệ thống dừng lại gây rò rỉ resource.
- Hiệu suất thấp: Sử dụng cấu hình chưa tối ưu, nhất là buffer, batch, hoặc không dùng librdkafka (đối với các thư viện dựa trên C).
- Không kiểm soát offset đúng cách: Offset không được commit đúng cách, gây duplicate hoặc mất dữ liệu.
- Không xử lý dữ liệu sai định dạng: Nhập dữ liệu không đúng cấu trúc hoặc encoding sai dẫn đến lỗi runtime.
Chìa khóa để tránh những lỗi này nằm ở việc hiểu rõ API, cấu hình đúng, và xây dựng quy trình xử lý lỗi rõ ràng, kiểm thử kỹ lưỡng.
Kết luận
Chọn đúng thư viện Kafka Python không chỉ giúp tối ưu hiệu suất, giảm thiểu lỗi mà còn phát huy tối đa khả năng của hệ thống stream dữ liệu. Dù bạn chọn Confluent Kafka Python, kafka-python hay Quix Streams thì điều quan trọng nhất vẫn là hiểu rõ tính năng, ưu nhược điểm và áp dụng đúng cách trong từng tình huống cụ thể.
Hy vọng bài viết này của Bizfly Cloud đã mang lại góc nhìn toàn diện và giúp bạn tự tin hơn khi làm việc với Kafka Python trong các ứng dụng của mình.