Kafka Connect là gì? Cách Kafka Connect giúp đồng bộ dữ liệu với Apache Kafka
Kafka Connect giúp kết nối Apache Kafka với database, file, object storage và nhiều hệ thống bên ngoài mà không cần tự viết toàn bộ pipeline tích hợp dữ liệu. Công cụ này đặc biệt hữu ích khi doanh nghiệp cần đồng bộ dữ liệu liên tục, dễ mở rộng và dễ kiểm soát lỗi trong quá trình vận hành. Trong bài viết này, chúng ta sẽ cùng Bizfly Cloud tìm hiểu Kafka Connect là gì, cách hoạt động và khi nào nên dùng trong hệ thống dữ liệu thực tế.
Kafka Connect là gì?
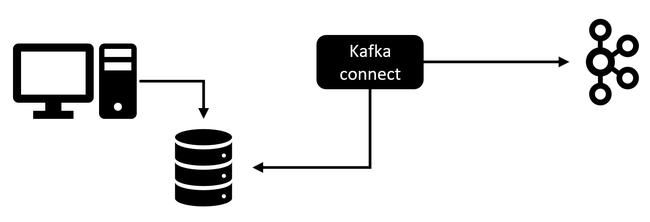
Kafka Connect là một framework/công cụ mã nguồn mở trong hệ sinh thái Apache Kafka
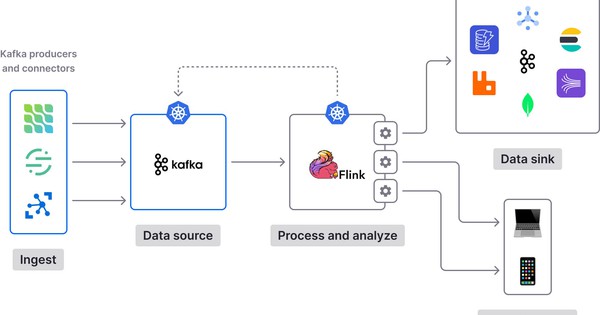
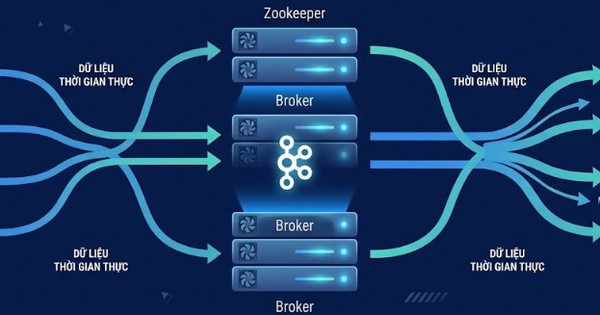
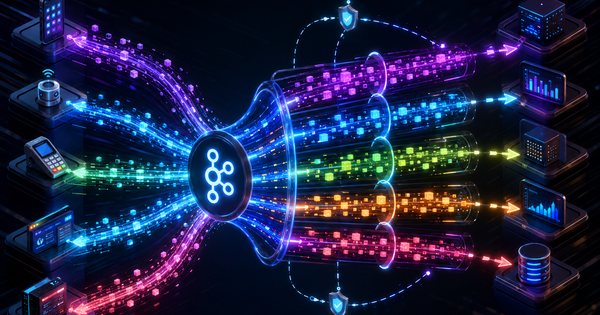
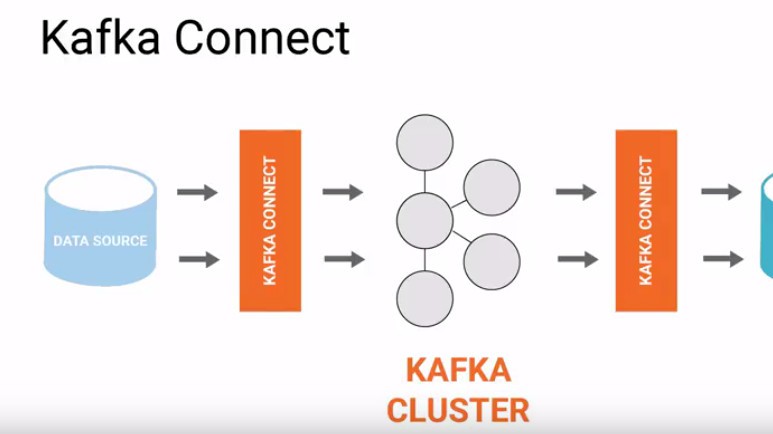
Kafka Connect là framework dùng để kết nối Apache Kafka với các hệ thống bên ngoài như database, data warehouse, object storage, search engine, file system hoặc các nền tảng cloud.
Nói đơn giản hơn: nếu Kafka là nơi nhận, lưu và phân phối luồng dữ liệu, thì Kafka Connect là lớp giúp dữ liệu đi vào Kafka hoặc đi ra khỏi Kafka một cách có kiểm soát.
Thay vì đội kỹ thuật phải tự viết từng đoạn code để đọc dữ liệu từ MySQL, PostgreSQL, MongoDB, S3, Elasticsearch hoặc một hệ thống nội bộ, Kafka Connect cho phép dùng các connector có sẵn. Mỗi connector đóng vai trò như một “bộ chuyển đổi” giữa Kafka và hệ thống cần tích hợp.
Ví dụ:
- Muốn đưa dữ liệu đơn hàng từ MySQL vào Kafka để xử lý real-time: dùng Source Connector
- Muốn đẩy log từ Kafka sang Elasticsearch để tìm kiếm và phân tích: dùng Sink Connector
- Muốn lưu dữ liệu streaming từ Kafka xuống S3 hoặc HDFS để phục vụ phân tích: dùng Sink Connector
Điểm quan trọng của Kafka Connect không chỉ nằm ở việc “kết nối được nhiều hệ thống”. Giá trị thật sự là nó xử lý sẵn nhiều phần vận hành khó chịu như quản lý offset, chia nhỏ tác vụ, tự phục hồi khi lỗi, mở rộng worker và giám sát trạng thái connector. Theo tài liệu Apache Kafka, ở chế độ distributed, Kafka Connect lưu cấu hình, offset và trạng thái task trong các Kafka topic nội bộ để phục vụ cân bằng tải và phục hồi lỗi.
Vì sao cần Kafka Connect?
Khi hệ thống còn nhỏ, việc viết một script để lấy dữ liệu từ database rồi đẩy vào Kafka có vẻ đơn giản. Nhưng khi dữ liệu chạy liên tục, lượng bản ghi tăng lên và có nhiều nguồn dữ liệu khác nhau, script tự viết sẽ nhanh chóng phát sinh vấn đề.
Một pipeline tích hợp dữ liệu thực tế phải trả lời được nhiều câu hỏi:
- Đọc dữ liệu từ đâu và đọc tiếp từ vị trí nào nếu tiến trình bị dừng?
- Nếu database mất kết nối vài phút thì pipeline xử lý ra sao?
- Nếu một bản ghi lỗi schema thì dừng toàn bộ hay bỏ qua bản ghi đó?
- Làm sao chạy song song nhiều tác vụ mà không đọc trùng dữ liệu?
- Khi cần tăng tải, có thể thêm worker mà không viết lại code không?
- Ai theo dõi connector đang chạy, đang pause hay đã failed?
Kafka Connect được sinh ra để xử lý những phần này theo một framework thống nhất. Đội kỹ thuật vẫn cần cấu hình, kiểm thử và giám sát cẩn thận, nhưng không phải xây lại toàn bộ cơ chế tích hợp từ đầu.
Kafka Connect hoạt động như thế nào?
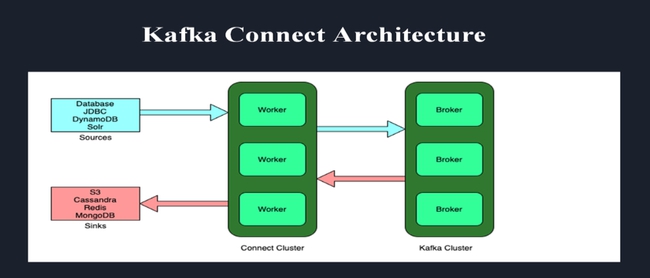
Kafka Connect vận hành theo mô hình khá rõ: connector mô tả công việc cần làm, task thực hiện việc sao chép dữ liệu, worker là tiến trình chạy các connector và task đó.
Một luồng cơ bản sẽ diễn ra như sau:
- Người quản trị tạo cấu hình connector
- Kafka Connect worker nhận cấu hình qua file hoặc REST API
- Connector chia công việc thành một hoặc nhiều task
- Task đọc dữ liệu từ nguồn hoặc ghi dữ liệu ra đích
- Kafka Connect lưu offset để biết dữ liệu đã xử lý đến đâu
- Nếu worker lỗi, task có thể được phân bổ lại sang worker khác trong chế độ distributed
Điểm cần hiểu đúng: connector không trực tiếp “ôm” toàn bộ dữ liệu để xử lý. Theo hướng dẫn phát triển connector của Apache Kafka, connector chịu trách nhiệm chia công việc thành các task, còn task mới là phần thực hiện sao chép dữ liệu giữa Kafka và hệ thống bên ngoài.
Các thành phần chính của Kafka Connect
Khi tìm hiểu về Kafka Connect, điều quan trọng là phải nắm rõ các thành phần cấu thành giúp nó vận hành trơn tru. Mỗi thành phần đều đóng vai trò riêng, hỗ trợ quá trình kết nối, đồng bộ dữ liệu diễn ra liên tục, hiệu quả.
Các thành phần chính gồm có:
1. Task
Task là đơn vị thực thi thực tế của connector.
Một connector có thể tạo một hoặc nhiều task tùy khả năng xử lý song song. Ví dụ, một JDBC Source Connector có thể chia nhiều bảng hoặc nhiều phân đoạn dữ liệu cho các task khác nhau. Một Sink Connector đọc nhiều Kafka partition cũng có thể chia việc cho nhiều task để tăng throughput.
Tuy nhiên, không phải cứ tăng tasks.max là hiệu năng tăng. Connector chỉ tạo được số task phù hợp với logic của nó và cấu trúc dữ liệu n
2. Connectors (Connector - Bộ kết nối)
Các connector chính là các plugin hoặc module giúp kết nối Kafka với các hệ thống nguồn hoặc đích. Có hai loại connector phổ biến:
- Source Connector: Lấy dữ liệu từ hệ thống bên ngoài rồi đẩy vào Kafka.
- Sink Connector: Lấy dữ liệu từ Kafka ra hệ thống đích như database, hệ thống phân phối khác.
Mỗi connector có thể được tùy chỉnh hoặc sử dụng sẵn theo nhu cầu. Điều đặc biệt là cộng đồng Kafka và các nhà cung cấp đã phát triển rất nhiều connector đa dạng, giúp việc tích hợp trở nên dễ dàng hơn.
3. Workers (Các worker)
Worker là tiến trình chạy Kafka Connect. Trong môi trường nhỏ hoặc thử nghiệm, có thể chạy một worker ở chế độ standalone. Trong môi trường production, nên dùng distributed mode để nhiều worker cùng tham gia xử lý, tự cân bằng tải và giảm rủi ro khi một worker gặp sự cố.
Apache Kafka khuyến nghị distributed mode cho các hệ thống cần mở rộng, vì chế độ này hỗ trợ tự động cân bằng công việc, tăng/giảm worker linh hoạt và có cơ chế chịu lỗi tốt hơn cho task, cấu hình và offset.
4. Converter
Converter quyết định cách Kafka Connect chuyển đổi dữ liệu giữa định dạng nội bộ của Connect và định dạng lưu trong Kafka.
Một số converter thường gặp:
JsonConverter: Dùng JSON, dễ đọc, phù hợp thử nghiệm hoặc hệ thống không quá chặt về schema.AvroConverter: Thường dùng với Schema Registry, phù hợp hệ thống cần quản lý schema nghiêm túc.StringConverter: Phù hợp dữ liệu text đơn giản.ByteArrayConverter: Dùng khi muốn giữ dữ liệu dạng byte.
Nếu chọn converter sai, connector có thể chạy nhưng dữ liệu ra topic khó đọc, sai schema hoặc gây lỗi khi sink connector tiêu thụ.
5. Offset Storage (Lưu trữ offset)
Offset giúp Kafka Connect biết dữ liệu đã xử lý đến đâu.
Với source connector, offset có thể là ID bản ghi, timestamp, vị trí trong file hoặc một metadata đặc thù của hệ thống nguồn. Với sink connector, offset thường gắn với Kafka topic, partition và vị trí bản ghi đã ghi ra hệ thống đích.
Nếu offset bị mất, sai hoặc reset không đúng, pipeline có thể đọc lại dữ liệu cũ, bỏ sót dữ liệu hoặc ghi trùng bản ghi. Vì vậy, offset không phải chi tiết phụ. Đây là phần quyết định độ tin cậy của toàn bộ luồng tích hợp.
6. Transform
Single Message Transform, thường gọi là SMT, cho phép biến đổi nhẹ từng bản ghi ngay trong Kafka Connect.
Ví dụ:
- Đổi tên field
- Thêm timestamp
- Loại bỏ field không cần thiết
- Đổi topic đích theo giá trị bản ghi
- Mask một số thông tin nhạy cảm
SMT phù hợp cho xử lý đơn giản. Nếu cần join dữ liệu phức tạp, aggregate, enrich theo nhiều nguồn hoặc xử lý nghiệp vụ sâu, nên dùng Kafka Streams, Flink, Spark Streaming hoặc một service riêng.
Cách triển khai Kafka Connect đúng hướng
Việc triển khai Kafka Connect đúng cách sẽ đảm bảo hệ thống hoạt động ổn định, dễ bảo trì và mở rộng trong tương lai. Dưới đây là hướng dẫn chi tiết từng bước, từ chuẩn bị môi trường đến kiểm tra, giám sát và tối ưu hệ thống.
Triển khai Kafka Connect giúp tự động hóa luồng dữ liệu giữa Kafka và các hệ thống bên ngoài
Bước 1: Xác định luồng dữ liệu
Đừng bắt đầu bằng câu hỏi “cài connector nào trước?”. Hãy bắt đầu bằng luồng dữ liệu:
- Dữ liệu đi từ đâu đến đâu?
- Là source hay sink?
- Dữ liệu cần realtime hay gần realtime?
- Có yêu cầu không mất dữ liệu không?
- Có chấp nhận ghi trùng không?
- Schema dữ liệu có thay đổi thường xuyên không?
- Nếu connector dừng 30 phút thì hệ thống có chịu được không?
Những câu hỏi này quyết định cách chọn connector, cấu hình offset, số task, định dạng dữ liệu và cách xử lý lỗi.
Bước 2: Chọn connector phù hợp
Không nên chọn connector chỉ vì “có sẵn”. Cần kiểm tra:
- Connector có hỗ trợ phiên bản hệ thống nguồn/đích đang dùng không?
- Có hỗ trợ scale bằng nhiều task không?
- Có tài liệu cấu hình rõ không?
- Có hỗ trợ retry, DLQ, schema, authentication không?
- Connector còn được duy trì hay đã cũ? License có phù hợp với môi trường doanh nghiệp không?
Với hệ thống quan trọng, nên ưu tiên connector có tài liệu tốt, cộng đồng dùng nhiều hoặc được nhà cung cấp hỗ trợ rõ ràng.
Bước 3: Tạo Connector
Worker cần biết Kafka cluster nào sẽ dùng để lưu dữ liệu và quản lý trạng thái. Trong distributed mode, ba topic nội bộ đặc biệt quan trọng là:
config.storage.topic: Lưu cấu hình connector và task.offset.storage.topic: Lưu offset.status.storage.topic: Lưu trạng thái connector và task.
Các topic này nên được tạo chủ động với replication factor, partition và cleanup policy phù hợp, thay vì để Kafka tự tạo bằng default không kiểm soát. Tài liệu Apache Kafka cũng khuyến nghị tạo thủ công các topic nội bộ này để đặt đúng số partition và replication factor mong muốn.
Bước 4: Tạo connector qua REST API
Kafka Connect cung cấp REST API để tạo, sửa, pause, resume, restart và kiểm tra connector. Trong distributed mode, REST API là cách quản lý chính.
Ví dụ cấu hình một JDBC Source Connector ở mức khái niệm:
{ "name": "mysql-orders-source", "config": { "connector.class": "JdbcSourceConnector", "connection.url": "jdbc:mysql://mysql:3306/shop", "connection.user": "connect_user", "connection.password": "********", "table.whitelist": "orders", "mode": "timestamp+incrementing", "timestamp.column.name": "updated_at", "incrementing.column.name": "id", "topic.prefix": "mysql.", "tasks.max": "2" }}Cấu hình thực tế sẽ phụ thuộc connector cụ thể. Không nên copy cấu hình mẫu lên production nếu chưa kiểm tra kỹ quyền truy cập, schema, offset, retry và cách xử lý dữ liệu lỗi.
Bước 5: Thiết lập xử lý lỗi
Mặc định, Kafka Connect có thể dừng connector khi gặp lỗi. Cách này an toàn vì không âm thầm bỏ qua dữ liệu, nhưng trong production, nhiều hệ thống cần cơ chế xử lý mềm hơn.
Có thể cấu hình:
- Retry trong một khoảng thời gian nhất định
- Ghi lỗi vào log
- Đẩy bản ghi lỗi sang Dead Letter Queue
- Bỏ qua một số lỗi chuyển đổi dữ liệu nếu đã chấp nhận rủi ro
Dead Letter Queue rất hữu ích khi một vài bản ghi lỗi schema nhưng không muốn dừng toàn bộ pipeline. Tuy nhiên, DLQ không phải thùng rác để quên đi. Cần có quy trình theo dõi, cảnh báo và xử lý lại dữ liệu lỗi.
Bước 6: Giám sát connector sau khi chạy
Một connector “RUNNING” chưa chắc đã ổn. Cần theo dõi thêm:
- Task có bị failed không?
- Throughput tăng giảm bất thường không?
- Consumer lag có tăng không?
- Offset có commit đều không?
- Có nhiều bản ghi vào DLQ không?
- Worker có thiếu RAM, CPU hoặc kết nối mạng không?
- REST API có bị mở ra mạng không đáng tin cậy không?
Về bảo mật, tài liệu Apache Kafka lưu ý REST API của Kafka Connect mặc định không có authentication; ai truy cập được REST port có thể tạo, sửa, dừng hoặc xóa connector. Vì vậy không nên để REST API lộ ra mạng không tin cậy.
Ví dụ thực tế: Đưa dữ liệu đơn hàng từ MySQL vào Kafka
Giả sử một doanh nghiệp có bảng orders trong MySQL. Mỗi khi có đơn hàng mới hoặc đơn hàng thay đổi trạng thái, dữ liệu cần được đưa vào Kafka để các hệ thống khác cùng sử dụng.
Luồng xử lý có thể là:
- JDBC Source Connector đọc bảng
orders - Connector xác định bản ghi mới dựa trên
idvàupdated_at - Dữ liệu được ghi vào topic
mysql.orders - Các service khác đọc topic này để cập nhật tồn kho, gửi email, phân tích hành vi hoặc đồng bộ sang data warehouse
- Nếu connector dừng, offset giúp nó đọc tiếp từ vị trí gần nhất thay vì đọc lại toàn bộ bảng
Với cách này, database không cần tích hợp trực tiếp với từng hệ thống phía sau. Kafka trở thành lớp trung gian phân phối dữ liệu, còn Kafka Connect đảm nhận việc đưa dữ liệu từ database vào Kafka.
Khi nào nên và không nên dùng Kafka Connect?
Việc chọn đúng công cụ giúp tối ưu hệ thống và tiết kiệm chi phí, thời gian là điều vô cùng quan trọng. Do đó, cần nắm rõ khi nào phù hợp để sử dụng Kafka Connect và khi nào không.
Nên dùng khi
- Bạn cần tích hợp dữ liệu liên tục, tự động và quy mô lớn giữa Kafka và các hệ thống bên ngoài.
- Có nhiều nguồn dữ liệu hoặc hệ thống đích cần đồng bộ, và mong muốn giảm thiểu việc viết mã thủ công.
- Yêu cầu độ trễ thấp, dữ liệu phải được xử lý gần như theo thời gian thực.
- Muốn hệ thống dễ mở rộng, chịu lỗi tốt và dễ bảo trì trong dài hạn.
Trong các trường hợp này, Kafka Connect mang lại lợi ích lớn về khả năng tự động hóa, khả năng mở rộng và quản lý tập trung, giúp doanh nghiệp tối ưu hoạt động dữ liệu.
Không nên dùng khi
- Dữ liệu cần xử lý phức tạp, tùy chỉnh cao mà connector không đáp ứng đủ yêu cầu.
- Hệ thống yêu cầu xử lý dữ liệu theo kiểu batch, không cần liên tục hoặc thời gian thực.
- Các hệ thống nguồn hoặc đích quá đặc thù, không có connector phù hợp, hoặc yêu cầu xử lý đặc biệt mà Kafka Connect không thể đáp ứng.
- Có giới hạn về tài nguyên hoặc không thể đảm bảo hoạt động liên tục của Kafka Connect do các lý do kỹ thuật hoặc bảo mật.
Trong các trường hợp này, phương pháp thủ công hoặc các công cụ tích hợp khác có thể phù hợp hơn, mặc dù sẽ tốn nhiều thời gian và công sức hơn.
Các lỗi thường gặp khi triển khai Kafka Connect
Triển khai Kafka Connect không phải lúc nào cũng suôn sẻ. Việc gặp lỗi là điều thường xuyên, đặc biệt trong giai đoạn đầu thiết lập. Hiểu rõ các lỗi phổ biến sẽ giúp bạn xử lý nhanh hơn và nâng cao hiệu quả vận hành.
Một số lỗi thường gặp gồm có:
- Lỗi cấu hình: Sai cú pháp, thiếu tham số cần thiết hoặc sai URL, port, tên người dùng, password… dẫn đến connector không hoạt động đúng hoặc không khởi động được.
- Lỗi kết nối mạng: Kafka Connect không thể liên lạc được với Kafka hoặc hệ thống nguồn/đích do vấn đề mạng hoặc firewall.
- Lỗi về offset: Dữ liệu bị mất hoặc bị trùng lặp do offset không được lưu đúng hoặc bị xóa mất.
- Tràn bộ nhớ hoặc quá tải: Worker hoặc connector xử lý quá nhiều dữ liệu cùng lúc gây treo hoặc chậm chạp.
- Lỗi liên quan đến phiên bản: Phiên bản connector không tương thích hoặc không phù hợp với Kafka hoặc hệ thống nguồn/đích.
- Vấn đề về bảo mật: Thiếu quyền truy cập, chứng thực không hợp lệ hoặc SSL/TLS không cấu hình đúng.
Việc theo dõi logs, sử dụng các công cụ giám sát, và kiểm thử kỹ cấu hình trước khi triển khai chính thức là cách tốt nhất để hạn chế các lỗi này.
Kết luận
Kafka Connect là một công cụ mạnh mẽ, giúp đơn giản hóa quá trình tích hợp dữ liệu trong hệ sinh thái Kafka. Với khả năng tự động hóa, mở rộng linh hoạt, khả năng chịu lỗi cao và cộng đồng phát triển mạnh mẽ, Kafka Connect đã trở thành lựa chọn hàng đầu cho các doanh nghiệp xây dựng hệ thống dữ liệu thời đại mới.
Tuy nhiên, để tận dụng tối đa các lợi ích của Kafka Connect, người dùng cần hiểu rõ các thành phần, cách hoạt động, biết cách cấu hình đúng và xử lý các lỗi phát sinh hiệu quả. Đồng thời, việc xác định đúng thời điểm phù hợp để sử dụng cũng đóng vai trò quan trọng trong thành công của dự án.
Hy vọng bài viết này đã cung cấp cho bạn cái nhìn toàn diện về Kafka Connect, giúp bạn dễ dàng hơn trong việc triển khai, vận hành và khai thác tối đa công cụ này cho các mục tiêu dữ liệu của mình.