GPU-Virtualization là gì? Cách hoạt động & ứng dụng
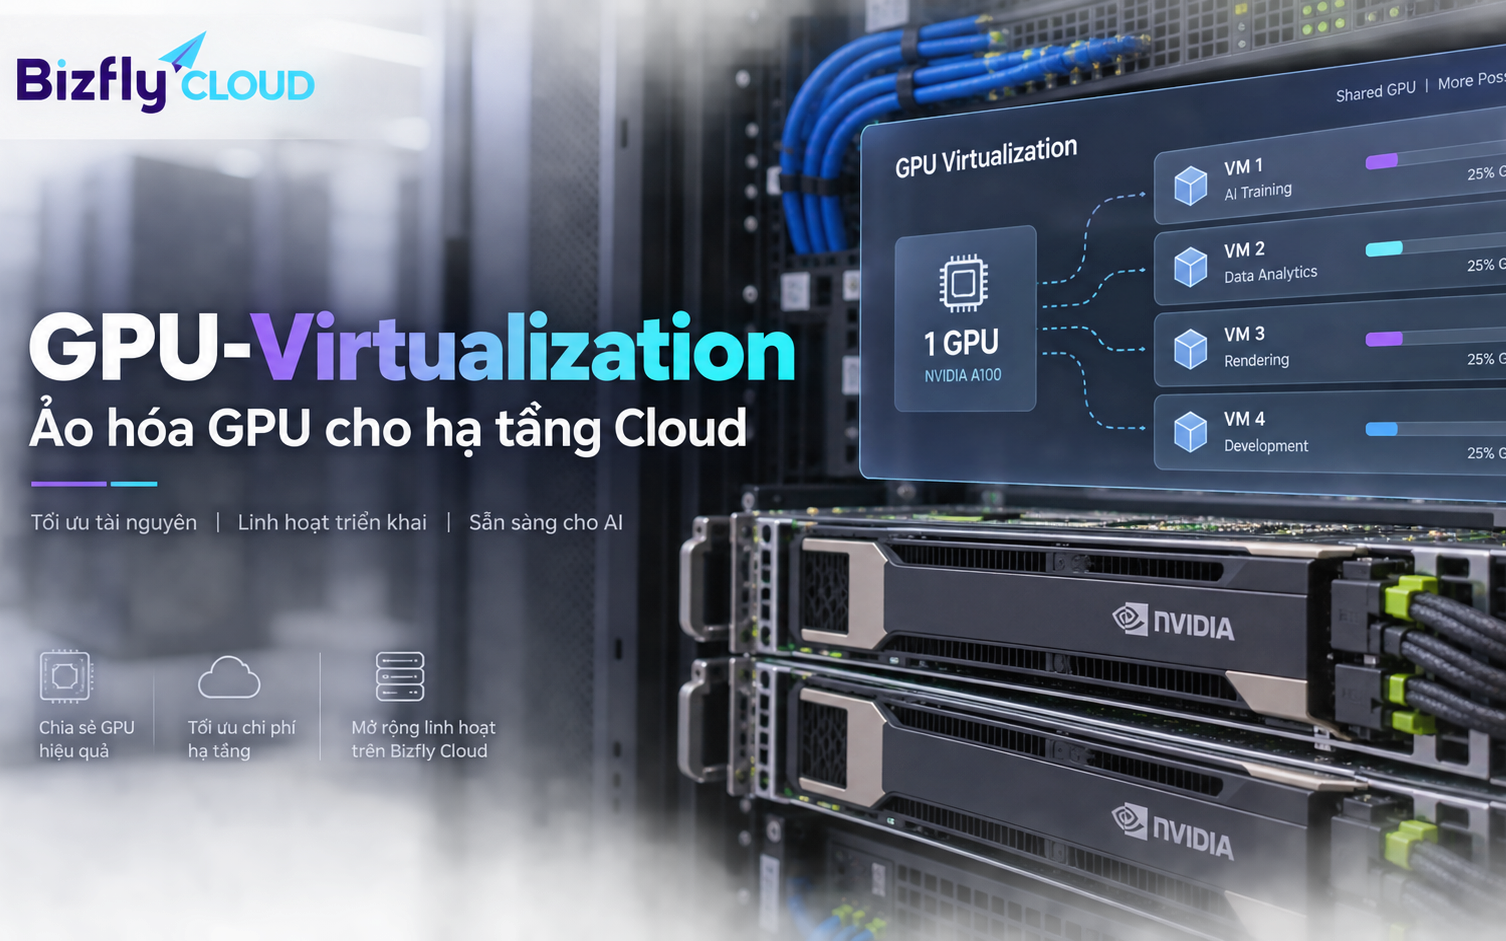
GPU-Virtualization giúp một GPU vật lý có thể phục vụ cho máy ảo, container hoặc nhiều người dùng thay vì chỉ gắn cố định cho một máy chủ. Nhưng không phải mô hình nào cũng giống nhau. Nếu chọn sai giữa GPU passthrough, vGPU và MIG, doanh nghiệp có thể gặp tình trạng lãng phí tài nguyên, hiệu năng không ổn định hoặc khó mở rộng khi workload AI tăng lên.
GPU Virtualization là gì?
GPU Virtualization là kỹ thuật cho phép tài nguyên GPU vật lý được đưa vào môi trường ảo hóa để máy ảo, desktop ảo, container hoặc workload tính toán có thể sử dụng GPU như một tài nguyên riêng.
Trước đây, GPU thường được gắn trực tiếp vào một máy chủ vật lý. Cách này phù hợp khi một ứng dụng cần toàn bộ sức mạnh GPU, nhưng lại kém linh hoạt nếu doanh nghiệp có nhiều nhóm cùng cần GPU ở các thời điểm khác nhau. GPU-Virtualization giải quyết bài toán đó bằng cách tách việc sử dụng GPU khỏi phần cứng vật lý cố định.
Trong thực tế, GPU-Virtualization có thể được triển khai theo nhiều cách. Có mô hình gán nguyên GPU cho một máy ảo, có mô hình chia GPU cho nhiều VM theo thời gian, cũng có mô hình chia GPU thành các phần cứng độc lập hơn như MIG trên một số dòng GPU NVIDIA. NVIDIA mô tả vGPU là công nghệ cho phép nhiều máy ảo truy cập đồng thời vào một GPU vật lý, còn MIG cho phép chia một GPU hỗ trợ MIG thành nhiều GPU instance riêng biệt cho workload CUDA.

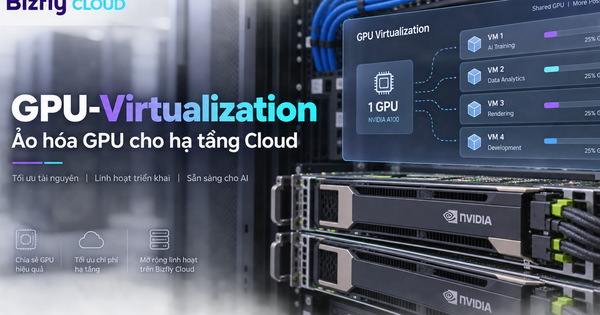
GPU-Virtualization là công nghệ cho phép chia sẻ sức mạnh của một bộ xử lý đồ họa vật lý thành nhiều phiên bản ảo
Vì sao GPU-Virtualization quan trọng hơn khi AI phát triển?
GPU không còn chỉ phục vụ đồ họa. Trong nhiều hệ thống hiện nay, GPU được dùng cho huấn luyện mô hình, inference, xử lý video, phân tích dữ liệu, mô phỏng kỹ thuật và desktop ảo hiệu năng cao.
Vấn đề là GPU đắt, tiêu thụ điện lớn và không phải workload nào cũng dùng hết tài nguyên GPU liên tục. Một nhóm AI có thể chỉ cần GPU mạnh trong vài giờ để fine-tune mô hình. Một nhóm thiết kế cần GPU vào giờ làm việc. Một hệ thống inference cần GPU chạy ổn định nhưng không nhất thiết chiếm trọn cả card.
Nếu không có ảo hóa GPU, doanh nghiệp thường rơi vào hai cực đoan: hoặc mua GPU dư công suất, hoặc để các nhóm tranh chấp tài nguyên. GPU-Virtualization giúp phân bổ GPU linh hoạt hơn, nhưng đổi lại cần hiểu rõ giới hạn kỹ thuật của từng mô hình.
GPU-Virtualization hoạt động trong hạ tầng Cloud như thế nào?
Trong môi trường cloud hoặc private cloud, GPU-Virtualization thường nằm giữa ba lớp: phần cứng GPU, hypervisor và máy ảo/container.
Ở lớp phần cứng, máy chủ cần GPU tương thích với mô hình triển khai. Không phải GPU nào cũng hỗ trợ vGPU hoặc MIG. Ở lớp hypervisor, nền tảng như VMware, KVM, Red Hat Virtualization hoặc các nền tảng cloud cần hỗ trợ cơ chế gán GPU. Ở lớp guest OS, VM cần driver phù hợp để nhận diện và sử dụng GPU.
Với container, bài toán thường đi thêm một lớp điều phối như Kubernetes. Khi đó, GPU cần được expose cho pod thông qua device plugin hoặc cơ chế tương thích. GPU-Virtualization trong Kubernetes không chỉ là “có GPU là chạy được”, mà còn liên quan đến scheduling, giới hạn tài nguyên, isolation và monitoring.
Các mô hình GPU-Virtualization phổ biến
Trong ảo hóa GPU, có ba phương pháp chính, mỗi loại đều có những ưu nhược điểm riêng.
GPU passthrough: Gán nguyên GPU cho một máy ảo
GPU passthrough là mô hình trong đó một GPU vật lý được gán trực tiếp cho một máy ảo. VM có thể truy cập GPU gần giống như đang chạy trên máy vật lý. Red Hat và Supermicro đều mô tả GPU passthrough là việc gán GPU vật lý cho một VM duy nhất thông qua cơ chế passthrough/VFIO hoặc PCIe passthrough.
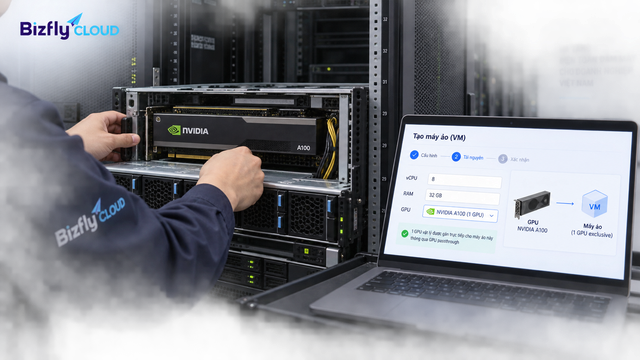
GPU passthrough cho phép gán trực tiếp một GPU vật lý cho một máy ảo, phù hợp với các workload cần hiệu năng cao và quyền truy cập phần cứng gần như độc lập.
Mô hình này phù hợp khi workload cần hiệu năng cao, độ trễ thấp và không muốn chia sẻ GPU với VM khác. Ví dụ: một máy ảo chạy training mô hình lớn, render 3D nặng hoặc ứng dụng cần toàn quyền kiểm soát GPU.
Điểm yếu của passthrough là khả năng chia sẻ kém. Một GPU thường chỉ phục vụ một VM tại một thời điểm. Nếu VM đó chỉ dùng 30% GPU trong phần lớn thời gian, phần còn lại vẫn khó tận dụng cho VM khác.
vGPU: Chia GPU cho nhiều máy ảo
vGPU cho phép một GPU vật lý được chia thành nhiều GPU ảo để cấp cho nhiều VM. Mỗi VM nhìn thấy một GPU riêng, nhưng tài nguyên thực tế vẫn đến từ cùng một GPU vật lý.
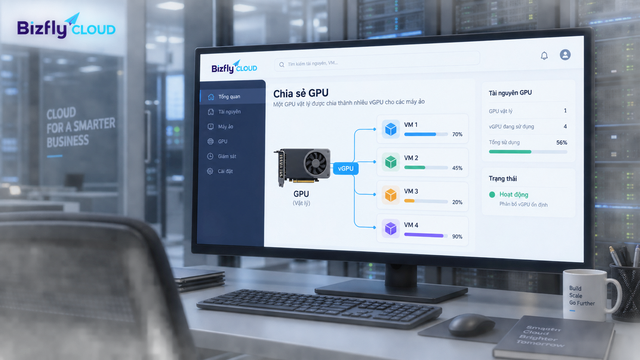
vGPU giúp một GPU vật lý được chia sẻ cho nhiều máy ảo, tối ưu tài nguyên hơn trong các môi trường cloud, VDI, dev/test hoặc AI workload không dùng GPU liên tục.
Mô hình này phù hợp với VDI, desktop đồ họa, môi trường phát triển AI, inference nhẹ hoặc các workload không cần chiếm trọn GPU. Ưu điểm là sử dụng tài nguyên tốt hơn, dễ cấp phát cho nhiều người dùng hơn và phù hợp với hạ tầng cloud/private cloud.
Tuy nhiên, vGPU cần phần mềm, driver, license và hypervisor tương thích. Khi nhiều VM cùng dùng GPU mạnh, hiệu năng có thể dao động tùy cách chia profile, bộ nhớ GPU, scheduler và đặc điểm workload.
Time-sliced vGPU: Nhiều VM dùng chung GPU theo lát thời gian
Time-sliced vGPU là cách chia GPU theo thời gian xử lý. Nhiều VM được cấp vGPU, nhưng GPU vật lý sẽ lần lượt phục vụ các VM theo cơ chế lập lịch.
Cách này hợp với workload có mức sử dụng GPU không liên tục, ví dụ desktop ảo, môi trường dev/test, inference nhỏ hoặc ứng dụng đồ họa không quá nặng. Nếu tất cả VM cùng chạy tác vụ nặng trong cùng thời điểm, hiệu năng từng VM có thể giảm.
MIG: Chia GPU thành nhiều phần độc lập hơn
MIG, viết tắt của Multi-Instance GPU, là công nghệ trên một số dòng GPU NVIDIA cho phép chia một GPU vật lý thành nhiều GPU instance. Theo NVIDIA, MIG có thể chia GPU hỗ trợ MIG thành tối đa 7 GPU instance riêng biệt cho ứng dụng CUDA, tùy dòng GPU và cấu hình.
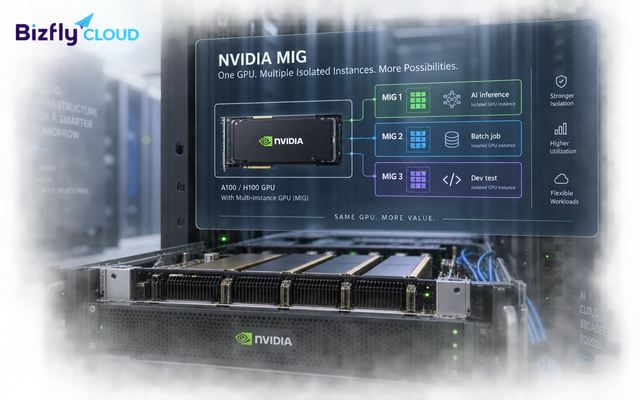
MIG cho phép chia một GPU hỗ trợ thành nhiều GPU instance riêng biệt, giúp nhiều workload AI có thể chạy song song với mức cách ly tài nguyên rõ ràng hơn.
Khác với time-sliced vGPU, MIG chia tài nguyên theo hướng cứng hơn: mỗi instance có phần tài nguyên tính toán, bộ nhớ và cache riêng ở mức nhất định. Vì vậy MIG thường phù hợp với workload AI inference, batch processing hoặc nhiều nhóm cần chạy tác vụ ổn định trên cùng một GPU.
MIG không phải lúc nào cũng thay thế vGPU. Doanh nghiệp cần kiểm tra GPU, driver, hypervisor và phần mềm hỗ trợ trước khi chọn.
Khi nào doanh nghiệp nên dùng GPU-Virtualization?
Khi nhiều nhóm cùng cần GPU nhưng không dùng liên tục
Nếu doanh nghiệp có nhóm AI, nhóm dữ liệu, nhóm thiết kế và nhóm dev cùng cần GPU, việc cấp riêng mỗi nhóm một máy chủ GPU có thể gây lãng phí. GPU-Virtualization giúp gom tài nguyên GPU vào một cụm hạ tầng và phân bổ theo nhu cầu.
Ví dụ, nhóm AI cần GPU để thử nghiệm mô hình vào ban ngày, nhóm xử lý video chạy batch ban đêm, nhóm dev chỉ cần GPU nhỏ để kiểm tra inference. Nếu thiết kế đúng, cùng một cụm GPU có thể phục vụ nhiều nhu cầu mà không phải nhân đôi phần cứng.
Khi triển khai VDI hoặc desktop đồ họa
VDI thông thường có thể chạy tốt với CPU. Nhưng nếu người dùng cần CAD, dựng hình, phân tích bản đồ, chỉnh sửa video hoặc ứng dụng 3D, GPU trở thành tài nguyên quan trọng.
vGPU phù hợp với nhóm này vì mỗi người dùng không cần một GPU vật lý riêng. Doanh nghiệp có thể cấp profile GPU theo vai trò: người dùng văn phòng nhẹ, designer, kỹ sư thiết kế hoặc nhóm render.
Khi chạy AI inference cho nhiều dịch vụ
AI inference thường cần GPU nhưng không phải request nào cũng dùng toàn bộ GPU. Nếu mỗi service inference chiếm riêng một GPU, chi phí rất dễ tăng nhanh. GPU-Virtualization hoặc MIG giúp chia tài nguyên GPU cho nhiều service nhỏ hơn, miễn là mô hình, latency và throughput được kiểm thử cẩn thận.
Khi cần chuẩn hóa môi trường GPU cho dev/test
Trong nhiều đội kỹ thuật, việc “máy tôi chạy được, server không chạy” xảy ra vì khác driver, CUDA, thư viện hoặc GPU. Khi GPU được đưa vào môi trường VM chuẩn hóa, đội dev có thể dùng image giống nhau, dễ tái tạo lỗi và giảm sai khác giữa môi trường thử nghiệm với production.
Khi nào không nên dùng GPU-Virtualization?
GPU-Virtualization không phải lựa chọn tốt cho mọi trường hợp. Nếu workload cần toàn bộ GPU liên tục, yêu cầu độ trễ cực thấp hoặc phụ thuộc sâu vào phần cứng, chạy bare-metal hoặc passthrough có thể phù hợp hơn.
Ngoài ra, nếu doanh nghiệp chưa có đội vận hành hiểu driver, hypervisor, license, monitoring GPU và tương thích phần mềm, triển khai vGPU quá sớm có thể làm hệ thống khó kiểm soát. GPU không giống CPU hay RAM. Khi lỗi xảy ra, nguyên nhân có thể nằm ở driver, CUDA version, firmware, hypervisor, profile vGPU hoặc chính ứng dụng.
Những lỗi thường gặp khi triển khai GPU-Virtualization
Chọn GPU trước khi hiểu workload
Nhiều doanh nghiệp bắt đầu bằng câu hỏi “nên mua GPU nào?” thay vì “workload cần gì?”. Với AI, cần xem mô hình dùng bao nhiêu VRAM, batch size, yêu cầu latency, framework, CUDA version và mức sử dụng GPU thực tế. Với VDI, cần xem số người dùng đồng thời, ứng dụng đồ họa, độ phân giải màn hình và mức tải trung bình.
Nếu chưa đo workload, việc chọn GPU rất dễ lệch: GPU quá yếu thì nghẽn, GPU quá mạnh thì lãng phí.
Nhầm vGPU với GPU passthrough
Passthrough và vGPU đều đưa GPU vào VM, nhưng bản chất khác nhau. Passthrough gán nguyên GPU cho một VM. vGPU chia GPU cho nhiều VM. Hai mô hình này khác nhau về hiệu năng, license, khả năng chia sẻ, live migration, quản trị và mức độ phù hợp với từng workload.
Không tính đến bộ nhớ GPU
Khi nói đến GPU, nhiều người chỉ nhìn số nhân CUDA hoặc hiệu năng tính toán. Nhưng với AI và đồ họa, VRAM thường là điểm nghẽn đầu tiên. Một mô hình có thể không chạy được nếu thiếu VRAM, dù GPU vẫn còn năng lực tính toán.
Khi chia vGPU hoặc MIG, cần xác định mỗi VM/service được cấp bao nhiêu bộ nhớ GPU và workload có thể chạy ổn định trong giới hạn đó hay không.
Thiếu monitoring GPU
CPU, RAM và disk thường được giám sát sẵn. GPU thì không phải lúc nào cũng được đưa vào dashboard vận hành. Nếu không theo dõi GPU utilization, memory usage, temperature, error, queue và mức dùng theo từng VM/container, đội vận hành rất khó biết hệ thống đang thiếu GPU thật hay chỉ phân bổ sai.
Với các hệ thống chạy trên cloud hoặc private cloud, doanh nghiệp nên kết hợp monitoring hạ tầng, cảnh báo tài nguyên và log ứng dụng. Đây là phần Bizfly Cloud có thể hỗ trợ ở lớp hạ tầng cloud, giám sát và thiết kế kiến trúc vận hành, thay vì chỉ nhìn GPU như một linh kiện riêng lẻ.
Cách chọn mô hình GPU-Virtualization phù hợp
Nếu ưu tiên hiệu năng tối đa: chọn passthrough
GPU passthrough phù hợp khi một workload cần toàn bộ GPU, ví dụ training mô hình lớn, render nặng hoặc ứng dụng kỹ thuật chuyên biệt. Đây là lựa chọn đơn giản hơn về mặt chia sẻ tài nguyên, nhưng kém linh hoạt nếu có nhiều nhóm cùng cần GPU.
Nếu ưu tiên chia sẻ cho nhiều VM: chọn vGPU
vGPU phù hợp khi doanh nghiệp cần cấp GPU cho nhiều máy ảo với mức tài nguyên khác nhau. Đây là mô hình thường gặp trong VDI, desktop đồ họa, lab AI, môi trường phát triển hoặc workload không dùng GPU liên tục.
Trước khi triển khai, cần kiểm tra GPU có hỗ trợ vGPU không, hypervisor có tương thích không, license cần loại nào và profile vGPU có đáp ứng workload không.
Nếu ưu tiên cách ly tài nguyên cho AI: cân nhắc MIG
MIG phù hợp khi một GPU mạnh cần phục vụ nhiều workload AI nhỏ hơn nhưng vẫn cần mức cách ly tài nguyên rõ ràng. Ví dụ, một GPU có thể được chia cho nhiều service inference, mỗi service chạy một model riêng.
Tuy nhiên, MIG phụ thuộc dòng GPU và hệ sinh thái hỗ trợ. Không nên mặc định rằng mọi GPU đều dùng được MIG.
GPU-Virtualization trong bài toán AI Cloud
Với AI Cloud, GPU-Virtualization giúp hạ tầng linh hoạt hơn ở ba điểm.
- Thứ nhất, doanh nghiệp có thể cấp GPU theo workload thay vì theo máy chủ vật lý. Một nhóm có thể dùng GPU lớn cho training, nhóm khác dùng phần nhỏ hơn cho inference hoặc dev/test.
- Thứ hai, việc chuẩn hóa VM/container giúp triển khai môi trường AI dễ kiểm soát hơn. Driver, CUDA, framework và dependency có thể được đóng gói theo image, giảm rủi ro sai khác môi trường.
- Thứ ba, tài nguyên GPU có thể được giám sát và tối ưu theo mức dùng thực tế. Đây là điểm quan trọng vì GPU thường là một trong những tài nguyên đắt nhất trong hạ tầng AI.
Với doanh nghiệp đang xây dựng hệ thống AI, chatbot, phân tích dữ liệu, xử lý ảnh/video hoặc inference nội bộ, Bizfly Cloud có thể đồng hành ở phần tư vấn kiến trúc cloud, máy chủ, lưu trữ, network, backup và monitoring. Với lớp GPU chuyên biệt, doanh nghiệp nên đánh giá kỹ workload, phần cứng và nền tảng ảo hóa trước khi quyết định mô hình triển khai.
Những câu hỏi thường gặp về GPU-Virtualization
GPU-Virtualization có làm giảm hiệu năng không?
Có thể có, tùy mô hình. GPU passthrough thường cho hiệu năng gần phần cứng vật lý nhất. vGPU có thể phát sinh overhead và bị ảnh hưởng khi nhiều VM cùng dùng GPU. MIG thường ổn định hơn cho workload phù hợp vì tài nguyên được chia rõ hơn, nhưng vẫn phụ thuộc phần cứng và cấu hình.
vGPU có giống GPU passthrough không?
Không. GPU passthrough gán nguyên GPU cho một máy ảo. vGPU chia một GPU vật lý cho nhiều máy ảo. Hai mô hình này khác nhau về cách cấp phát tài nguyên, khả năng chia sẻ, license và vận hành.
MIG có phải là vGPU không?
MIG không hoàn toàn giống vGPU. MIG là công nghệ chia GPU thành nhiều GPU instance ở mức phần cứng trên một số GPU NVIDIA. MIG có thể kết hợp với môi trường ảo hóa để cấp GPU instance cho VM hoặc workload, nhưng không phải GPU nào cũng hỗ trợ MIG.
GPU-Virtualization có dùng cho Kubernetes được không?
Có, nhưng cần thiết kế đúng. Kubernetes cần cơ chế nhận diện và cấp phát GPU cho container, thường thông qua device plugin hoặc nền tảng hỗ trợ GPU. Nếu dùng MIG hoặc vGPU, cần kiểm tra khả năng tương thích giữa GPU, driver, container runtime và scheduler.
Doanh nghiệp nhỏ có nên dùng GPU-Virtualization không?
Nếu chỉ có một workload dùng toàn bộ GPU, chưa chắc cần GPU-Virtualization. Nhưng nếu có nhiều nhóm, nhiều VM hoặc nhiều service AI cùng cần GPU ở mức khác nhau, GPU-Virtualization giúp tận dụng tài nguyên tốt hơn và dễ mở rộng hơn.
Kết luận
GPU-Virtualization không chỉ là kỹ thuật “ảo hóa card đồ họa”. Đây là cách tổ chức lại tài nguyên GPU để phục vụ nhiều workload AI, đồ họa, VDI và cloud hiệu quả hơn. Điểm quan trọng không phải chọn công nghệ mới nhất, mà là chọn đúng mô hình: passthrough cho hiệu năng tối đa, vGPU cho chia sẻ linh hoạt, MIG cho workload AI cần cách ly tài nguyên rõ hơn.
Với doanh nghiệp đang chuẩn bị đầu tư hạ tầng GPU, nên bắt đầu từ workload thực tế: cần bao nhiêu VRAM, bao nhiêu người dùng hoặc service chạy đồng thời, yêu cầu latency ra sao và đội vận hành có đủ năng lực quản trị GPU hay chưa. Khi trả lời được các câu hỏi đó, GPU-Virtualization mới thực sự giúp tối ưu chi phí và hiệu năng, thay vì trở thành một lớp phức tạp khó kiểm soát.