
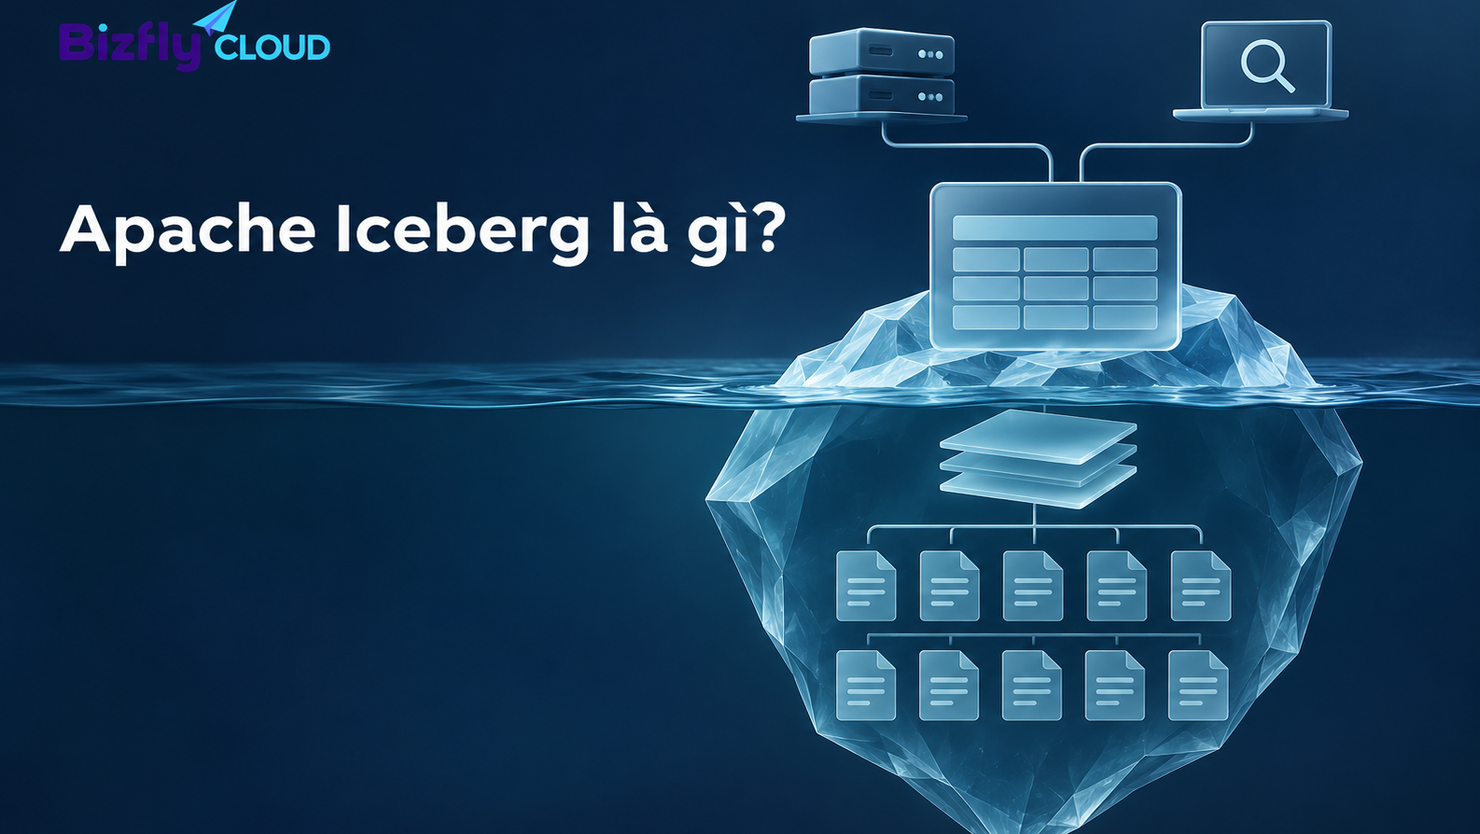
Khi dữ liệu phân tích tăng lên, việc quản lý các file Parquet hoặc ORC trong data lake có thể trở nên khó khăn: thay đổi cấu trúc bảng dễ ảnh hưởng dữ liệu cũ, truy vấn phải phụ thuộc vào cách chia thư mục, còn nhiều công cụ có thể không thống nhất về phiên bản dữ liệu đang đọc. Apache Iceberg bổ sung một lớp quản lý bảng lên trên các file này để xử lý những vấn đề đó.
Apache Iceberg là gì?
Apache Iceberg là một định dạng bảng mở (open table format) dành cho các tập dữ liệu phân tích lớn. Iceberg quản lý dữ liệu được lưu trong các file riêng lẻ như Parquet, Avro hoặc ORC, đồng thời theo dõi cấu trúc bảng, cách phân vùng, danh sách file và các phiên bản dữ liệu. Các công cụ như Spark, Trino, Flink, Hive và Impala có thể sử dụng Iceberg để đọc và ghi bảng.
Iceberg thường là một thành phần trong kiến trúc data lake. Nếu cần tìm hiểu bối cảnh về Big Data và Data Lake, có thể tham khảo bài Big Data là gì?.
Apache Iceberg là một định dạng bảng dữ liệu mở (open table format) hiệu năng cao
Iceberg không phải cơ sở dữ liệu, công cụ xử lý dữ liệu hay nơi lưu trữ. Có thể hình dung các thành phần trong một hệ thống như sau:
| Thành phần | Vai trò |
|---|---|
| Object storage hoặc hệ thống file phân tán | Lưu dữ liệu và metadata |
| Parquet, Avro hoặc ORC | Định dạng các file dữ liệu |
| Apache Iceberg | Quản lý bảng, metadata, snapshot và cách truy cập file |
| Spark, Trino, Flink… | Xử lý, truy vấn hoặc ghi dữ liệu |
| Catalog | Theo dõi bảng và metadata hiện hành để các công cụ tìm, truy cập bảng |
Điểm cần nhớ: Iceberg quản lý bảng được tạo từ nhiều file, chứ không thay thế các thành phần còn lại trong kiến trúc dữ liệu.
Apache Iceberg hoạt động như thế nào?
Một bảng Iceberg gồm các file dữ liệu và một lớp metadata mô tả trạng thái bảng. Metadata ghi nhận schema, cấu hình phân vùng, snapshot và các file thuộc về bảng. Các manifest giúp liệt kê file cùng thông tin như partition và chỉ số dữ liệu; catalog giúp công cụ tìm metadata hiện hành của bảng.
Apache Iceberg là một định dạng bảng mở (open table format) dành cho kho dữ liệu lớn
Quy trình ghi dữ liệu có thể hiểu theo các bước:
- Công cụ xử lý, chẳng hạn Spark hoặc Flink, ghi các file dữ liệu vào nơi lưu trữ. Người mới tìm hiểu Spark có thể đọc thêm bài Apache Spark là gì?.
- Iceberg tạo metadata mô tả trạng thái bảng mới, bao gồm file nào được thêm hoặc không còn thuộc snapshot hiện tại.
- Catalog cập nhật metadata hiện hành của bảng.
- Công cụ đọc bảng dựa trên snapshot đã được ghi nhận, thay vì phải tự suy luận trạng thái bảng từ tên thư mục hoặc danh sách file.
Việc ghi thay đổi thông qua commit giúp người đọc truy vấn một trạng thái bảng hoàn chỉnh, thay vì nhìn thấy một phần của thay đổi chưa hoàn tất. Iceberg cũng hỗ trợ cơ chế kiểm soát đồng thời theo hướng optimistic concurrency; khả năng xử lý cụ thể còn phụ thuộc catalog và công cụ tích hợp.
Iceberg giải quyết những vấn đề nào?
Apache Iceberg giải quyết các hạn chế truyền thống của bảng Apache Hive và kiến trúc hồ dữ liệu
Thay đổi cấu trúc bảng mà không phải viết lại toàn bộ dữ liệu
Trong quá trình sử dụng, bảng có thể cần thêm, bỏ, đổi tên hoặc điều chỉnh kiểu dữ liệu của cột. Iceberg theo dõi các trường bằng ID riêng, nhờ đó việc thay đổi schema có thể được thực hiện an toàn hơn với dữ liệu đã ghi. Những thay đổi schema này chủ yếu được ghi vào metadata, không bắt buộc phải viết lại toàn bộ file dữ liệu.
Ví dụ, bảng sự kiện ban đầu chỉ có user_id, event_name và event_time. Khi cần bổ sung device_type, nhóm dữ liệu có thể cập nhật schema để thêm cột mới mà không cần tạo một bảng khác chỉ để chứa dữ liệu phát sinh sau này.
Thay đổi cách phân vùng khi truy vấn thay đổi
Phân vùng giúp công cụ bỏ qua những file không liên quan đến truy vấn. Nhưng nếu truy vấn phải biết chính xác cách thư mục được chia, thay đổi cách phân vùng có thể buộc đội dữ liệu sửa lại cách ghi hoặc truy vấn.
Iceberg hỗ trợ hidden partitioning: người dùng lọc theo cột logic, còn Iceberg quản lý phép biến đổi và thông tin phân vùng. Chẳng hạn, bảng log có thể được phân vùng theo ngày từ event_time; truy vấn vẫn lọc theo khoảng thời gian mà không cần tự tạo hay lọc cột event_date. Khi cần đổi cách phân vùng, dữ liệu cũ và dữ liệu mới có thể tiếp tục được quản lý trong cùng bảng theo các partition spec khác nhau.
Đọc lại trạng thái dữ liệu tại một thời điểm
Mỗi lần ghi tạo ra một snapshot mới của bảng. Time travel cho phép truy vấn một snapshot cũ để kiểm tra dữ liệu tại thời điểm trước đó hoặc tái lập kết quả phân tích. Tùy công cụ, người dùng cũng có thể đưa bảng về một snapshot hợp lệ trước đó.
Snapshot không đồng nghĩa với bản sao lưu độc lập. Nếu hệ thống hết hạn snapshot cũ, dữ liệu không còn được giữ lại để truy vấn theo thời gian hoặc rollback. Vì thế, thời gian lưu snapshot cần phù hợp với yêu cầu kiểm toán, khôi phục và chi phí lưu trữ.
Truy vấn có thể bỏ qua file không cần đọc
Iceberg lưu metadata và thống kê ở cấp file, giúp công cụ lập kế hoạch truy vấn và loại bỏ các file không khớp với điều kiện lọc. Hiệu quả thực tế vẫn phụ thuộc vào engine, cách tổ chức dữ liệu, mẫu truy vấn và việc bảo trì bảng; có Iceberg không tự động khiến mọi truy vấn nhanh hơn.
Apache Iceberg khác Parquet, data lake và query engine thế nào?
| Thành phần | Câu hỏi mà thành phần đó trả lời |
|---|---|
| Parquet | Các hàng và cột trong một file được mã hóa, nén và tổ chức ra sao? |
| Object storage | Các file dữ liệu được lưu ở đâu? |
| Apache Iceberg | File nào tạo thành bảng, schema hiện tại là gì và snapshot nào cần được đọc? |
| Spark, Trino hoặc Flink | Dữ liệu được xử lý, truy vấn hoặc ghi bằng công cụ nào? |
| Data lake | Dữ liệu được tập trung lưu trữ theo mô hình kiến trúc nào? |
Object storage lưu các file; Iceberg quản lý chúng thành bảng có metadata và snapshot. Để phân biệt lớp lưu trữ này với table format, có thể tham khảo bài Object Storage là gì và khác lưu trữ truyền thống thế nào?.
Khi nào doanh nghiệp nên cân nhắc Apache Iceberg?
Iceberg phù hợp để đánh giá khi doanh nghiệp có một hoặc nhiều nhu cầu sau:
- Lưu lượng dữ liệu phân tích lớn và cần quản lý bảng qua nhiều công cụ.
- Schema thay đổi theo thời gian, nhưng muốn giữ khả năng đọc dữ liệu cũ.
- Cần thay đổi partitioning khi kiểu truy vấn hoặc quy mô dữ liệu thay đổi.
- Muốn truy vấn lại snapshot cũ để đối soát hoặc tái lập kết quả.
- Có data lake trên object storage và cần quản lý các file thành những bảng có trạng thái rõ ràng.
Nếu hệ thống chỉ có một số bảng nhỏ, ít thay đổi và được phục vụ tốt bởi cơ sở dữ liệu hoặc data warehouse hiện tại, thêm Iceberg có thể làm tăng công sức vận hành mà chưa đem lại lợi ích tương xứng.
Những điểm cần tính trước khi triển khai
Iceberg không cung cấp trọn bộ nền tảng dữ liệu
Doanh nghiệp vẫn cần chọn nơi lưu trữ, catalog, engine đọc ghi, công cụ nhập dữ liệu và cơ chế phân quyền. Trước khi triển khai, cần kiểm tra phiên bản của engine và catalog hỗ trợ những thao tác Iceberg nào. Khả năng đọc bảng không đồng nghĩa với việc mọi công cụ đều hỗ trợ đầy đủ các thao tác ghi, xóa, time travel hay bảo trì.
Cần bảo trì snapshot và file dữ liệu
Các job ghi dữ liệu thường xuyên, đặc biệt là job streaming, có thể tạo nhiều snapshot và file nhỏ. File nhỏ làm tăng metadata và chi phí mở file khi truy vấn. Tài liệu Apache Iceberg khuyến nghị xem xét các thao tác như compact data files, viết lại manifest và hết hạn snapshot cũ để kiểm soát hiệu năng và dung lượng lưu trữ. Cần đặt chính sách snapshot cẩn thận vì hết hạn snapshot sẽ giới hạn khả năng time travel.
Không mặc định phù hợp cho mọi truy vấn thời gian thực
Iceberg là định dạng quản lý bảng; nó không thay thế message broker hay bộ xử lý luồng. Độ trễ từ lúc phát sinh sự kiện đến khi dữ liệu xuất hiện trong bảng phụ thuộc vào engine, cách gom lô và tần suất commit. Các bảng streaming cũng cần kế hoạch bảo trì metadata và file.
Ví dụ kiến trúc sử dụng Apache Iceberg
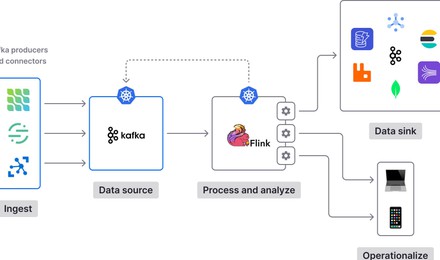
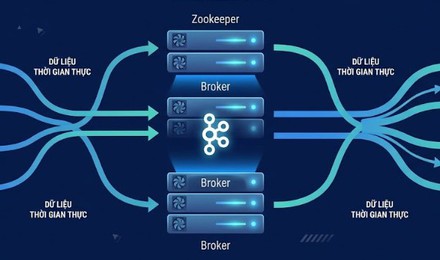
Một hệ thống phân tích hành vi website có thể nhận sự kiện từ ứng dụng, chuyển sự kiện qua Kafka, rồi dùng Spark hoặc Flink xử lý và ghi thành bảng Iceberg trên object storage. Nhóm phân tích sau đó dùng Trino hoặc Spark để truy vấn dữ liệu lịch sử.
Kiến trúc sử dụng Apache Iceberg phổ biến nhất hiện nay là mô hình Open Data Lakehouse
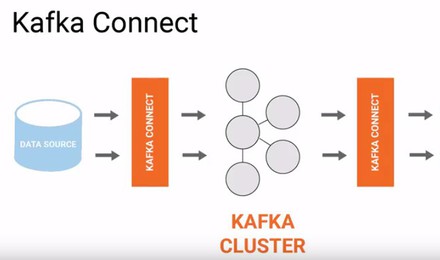
Trong pipeline này, Kafka Connect có thể kết nối Kafka với các hệ thống nguồn hoặc đích thông qua connector; cần kiểm tra connector cụ thể có hỗ trợ đích Iceberg dự kiến hay không. bizflycloud.vn
Với hạ tầng Bizfly Cloud, doanh nghiệp có thể tham khảo Bizfly Cloud Kafka cho lớp truyền tải sự kiện và Bizfly Cloud Simple Storage cho lớp lưu trữ object. Simple Storage có API tương thích AWS S3; để triển khai Iceberg, vẫn cần kiểm tra khả năng tích hợp của engine, catalog, quyền truy cập và cấu hình lưu trữ trong kiến trúc cụ thể.
Câu hỏi thường gặp về Apache Iceberg
Apache Iceberg có phải cơ sở dữ liệu không?
Không. Iceberg là định dạng bảng mở quản lý metadata và trạng thái bảng. Muốn truy vấn hoặc ghi dữ liệu, vẫn cần một engine như Spark, Trino hoặc Flink cùng storage và catalog phù hợp.
Apache Iceberg có bắt buộc dùng Parquet không?
Không. Iceberg hỗ trợ các định dạng file dữ liệu phân tích như Parquet, Avro và ORC. Cần kiểm tra định dạng và thao tác cụ thể mà engine trong hệ thống hỗ trợ.
Apache Iceberg có thay thế data warehouse không?
Không tự thân. Iceberg có thể là lớp quản lý bảng trong data lake hoặc lakehouse, nhưng không cung cấp toàn bộ chức năng của data warehouse, như tài nguyên truy vấn được quản lý, giao diện phân tích hay các cơ chế quản trị mà doanh nghiệp có thể đang sử dụng.
Có thể dùng Kafka trực tiếp với Iceberg không?
Kafka không tự ghi dữ liệu thành bảng Iceberg. Một engine hoặc connector cần đọc sự kiện từ Kafka, xử lý dữ liệu và ghi vào bảng. Vì vậy, cần thiết kế riêng lớp nhập liệu, xử lý và quản lý bảng.
Apache Iceberg giúp quản lý các file dữ liệu phân tích thành bảng có schema, snapshot và metadata nhất quán. Iceberg đáng cân nhắc khi data lake cần thay đổi schema, điều chỉnh phân vùng, truy vấn lịch sử hoặc được sử dụng bởi nhiều engine. Trước khi áp dụng, hãy đánh giá cả catalog, engine, storage, khả năng tương thích và kế hoạch bảo trì bảng vì Iceberg chỉ là một phần của kiến trúc dữ liệu.