Tìm hiểu các tính năng mới trong Kubernetes 1.37: autoscaling về 0 (scale-to-zero autoscaling), lập lịch theo nhóm (gang scheduling), quản lý tài nguyên ở cấp pod, tăng cường kiểm soát admission và cải thiện quản lý bộ nhớ.
Giới thiệu
Kubernetes 1.37, có tên Garhwal, được phát hành vào ngày 26/8/2026. Phiên bản này có 67 cải tiến: 16 tính năng đạt Stable, 23 chuyển sang Beta và 27 bước vào Alpha.
Như các bản phát hành Kubernetes khác, danh sách đầy đủ có nhiều thay đổi chỉ phù hợp cho một số team vận hành và team phát triển nền tảng cụ thể. Bạn không cần đọc cả 67 thay đổi để hiểu những điểm đáng chú ý của phiên bản này.
Bài viết sẽ tập trung vào 5 thay đổi nổi bật đối với người dùng Kubernetes thông thường và các team vận hành workload quy mô lớn hoặc có yêu cầu cao.
1. HPA có thể scale workload về 0
Kubernetes 1.37 đưa tính năng HPA scale-to-zero lên Beta, được bật mặc định.
Trước đây, để giảm số lượng bản copy của workload về 0, thường cần công cụ bổ sung hoặc tính năng Kubernetes thử nghiệm. Giờ đây, Kubernetes có thể xử lý trực tiếp khi HPA sử dụng metric kiểu object hoặc external.
Cấu hình sẽ như sau:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: queue-worker
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: queue-worker
minReplicas: 0
maxReplicas: 10
- Khi không có công việc cần xử lý, Kubernetes có thể giảm workload xuống còn 0 Pod.
- Khi metric bên ngoài cho thấy có công việc mới, HPA có thể tăng số lượng Pod trở lại.
Tính năng này phù hợp với các workload như:
- Queue consumer
- Batch processor
- Service ít được sử dụng
- Workload GPU thường xuyên ở trạng thái nhàn rỗi
Hạn chế quan trọng: Metric tài nguyên CPU và memory không thể kích hoạt mở rộng từ 0, vì Kubernetes không thể đo các metric này khi không có Pod. Cần sử dụng metric kiểu object hoặc external để cung cấp tín hiệu.
Với các workload chấp nhận được thời gian khởi động lại, tính năng này có thể giúp giảm đáng kể mức tiêu thụ tài nguyên.
2. Gang Scheduling chuyển sang Beta
Kubernetes ngày càng được sử dụng nhiều cho workload AI/ML. Việc schedule cho các nhóm Pod lớn cũng đặt ra những vấn đề riêng.
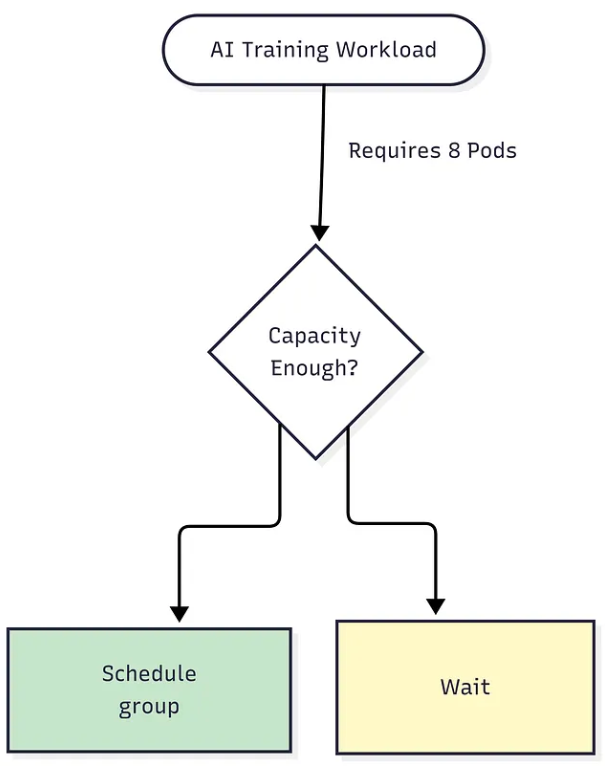
Ví dụ, một tác vụ huấn luyện AI cần 8 Pod. Scheduler thông thường có thể khởi chạy một số Pod trong khi các Pod còn lại vẫn ở trạng thái chờ:
Pod 1 → Running
Pod 2 → Running
Pod 3 → Running
Pod 4 → Running
Pod 5 → Pending
Pod 6 → Pending
Pod 7 → Pending
Pod 8 → Pending
Workload có thể không tiến triển cho đến khi cả 8 Pod đều sẵn sàng.
Gang scheduling giải quyết vấn đề này bằng cách cho phép Kubernetes lập lịch một nhóm Pod như một đơn vị. Scheduler có thể chờ đến khi cluster đủ tài nguyên thay vì chỉ lập lịch một phần workload.
Kubernetes 1.37 đưa gang scheduling lên Beta và bổ sung các khả năng liên quan như workload-aware preemption và PodGroup queueing.
Khái niệm này có thể được trình bày như sau:
Điều này cũng hữu ích cho HPC và các workload cần nhiều Pod phối hợp hoạt động.
Tính năng này vẫn bị tắt mặc định trong Kubernetes 1.37. Các team cần bật những feature gate tương ứng trước khi sử dụng.
3. Quản lý tài nguyên ở Pod level
Kubernetes truyền thống quản lý CPU và memory chủ yếu ở container level.
Kubernetes 1.37 đưa các trình quản lý tài nguyên cấp Pod lên Beta.
Nhờ đó, CPU Manager, Memory Manager và Topology Manager có thể phân bổ tài nguyên dựa trên cấu hình của toàn bộ Pod.
Ví dụ, một Pod có thể gồm application container chính và một sidecar:
apiVersion: v1
kind: Pod
metadata:
name: workload
spec:
resources:
requests:
cpu: "4"
memory: "8Gi"
limits:
cpu: "4"
memory: "8Gi"
containers:
- name: application
image: example/app
- name: sidecar
image: example/sidecar
Mô hình lấy Pod làm trung tâm giúp Kubernetes linh hoạt hơn khi phân bổ tài nguyên giữa các container.
Tính năng này đặc biệt hữu ích với workload yêu cầu hiệu năng cao, như AI/ML và điện toán hiệu năng cao (HPC), nơi việc bố trí CPU và bộ nhớ rất quan trọng.
Ví dụ, Kubernetes có thể dành riêng một vùng tài nguyên phù hợp với NUMA cho Pod, cho phép một container sử dụng tài nguyên chuyên biệt trong khi các container khác chia sẻ phần tài nguyên còn lại.
Tính năng này vẫn bị tắt mặc định, nên hiện phù hợp hơn với các quản trị viên cluster vận hành workload chuyên biệt thay vì phần lớn lập trình viên ứng dụng.
4. Admission Control có thể sử dụng các file trên Disk
Admission control là một trong những cơ chế bảo mật quan trọng nhất của Kubernetes, cho phép áp dụng các quy tắc trước khi API server chấp nhận tài nguyên.
Trong Kubernetes 1.37, cấu hình admission control dựa trên manifest chuyển sang Beta.
Admission webhook và policy dựa trên CEL có thể tải cấu hình từ các tệp manifest trên hệ thống tệp của API server, thay vì chỉ sử dụng cấu hình lưu qua Kubernetes API.
Kiến trúc như sau:
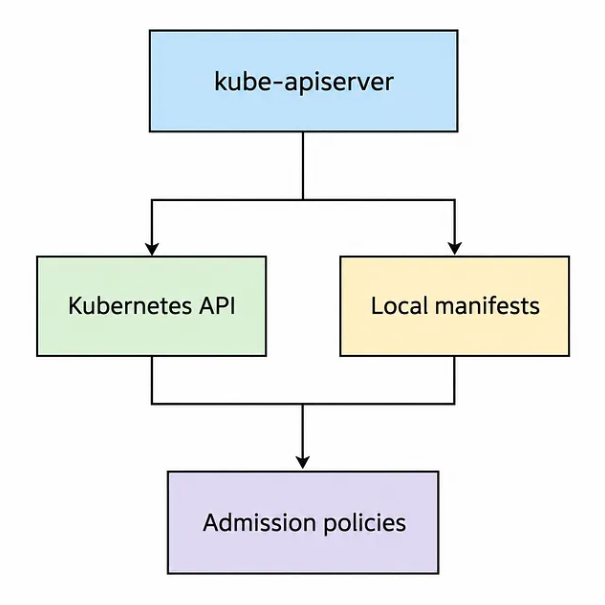
Điều này mang lại lợi ích khi khởi động hoặc khôi phục cluster: API server vẫn có thể thực thi các policy này ngay cả khi etcd không khả dụng.
Cơ chế này cũng giúp dmin bảo vệ cấu hình admission được lưu trong Kubernetes API khỏi bị chỉnh sửa hoặc xóa.
Tính năng này đặc biệt hữu ích với các team platform và security, vì cho phép quản lý một số cấu hình policy quan trọng bên ngoài vòng đời thông thường của Kubernetes API.
5. Memory QoS và chuyển đổi sang cgroups v2
Kubernetes 1.37 tiếp tục chuyển sang cgroups v2 và cải thiện khả năng quản lý bộ nhớ thông qua Memory QoS.
Linux cgroups kiểm soát tài nguyên mà các tiến trình có thể sử dụng. Kubernetes sử dụng cơ chế này để áp dụng các giới hạn và yêu cầu tài nguyên cho container.
Với cgroups v2, Kubernetes có thể sử dụng chính xác hơn các tham số như:
memory.min
memory.low
memory.high
Nhờ đó, Kubernetes có thể bảo vệ các workload quan trọng khi thiếu memory và kiểm soát cách kernel xử lý tình trạng tranh chấp memory.
Một điểm cần lưu ý khi nâng cấp: Kubernetes đang dần loại bỏ cgroups v1. Kubernetes 1.37 vẫn cung cấp tùy chọn tạm thời failCgroupV1: false cho các node cần thêm thời gian chuyển đổi, nhưng cgroups v2 nên là mục tiêu đối với các cluster mới và cluster được nâng cấp.
Điều này có nghĩa là các tính năng quản lý tài nguyên mới của Kubernetes phụ thuộc vào cgroups v2.
Các thay đổi đáng chú ý khác
Năm tính năng trên là những điểm đáng quan tâm nhất, nhưng Kubernetes 1.37 còn có một số thay đổi khác.
KYAML chính thức ổn định
KYAML là một tập con của YAML, được thiết kế để an toàn hơn và giảm sự mơ hồ khi sử dụng trong Kubernetes.
Các tệp YAML hiện có vẫn hợp lệ. Bạn cũng có thể sử dụng lệnh:
kubectl get deployment my-app -o kyaml
KYAML đạt trạng thái Stable trong Kubernetes 1.37.
Metrics API chính thức ổn định
API metrics.k8s.io cuối cùng đã đạt trạng thái Stable sau nhiều năm ở giai đoạn Beta. API này cung cấp thông tin sử dụng CPU và bộ nhớ của Pod, node, đồng thời hỗ trợ các lệnh quen thuộc như:
kubectl top pods
kubectl top nodes
API này cũng hỗ trợ chức năng HPA dựa trên tài nguyên. Phiên bản API ổn định là metrics.k8s.io/v1.
StatefulSet bổ sung chiến lược Recreate
StatefulSet hiện hỗ trợ chiến lược cập nhật Recreate ở giai đoạn Alpha.
Thay vì cập nhật từng Pod, Kubernetes sẽ xóa các Pod thuộc StatefulSet trước khi tạo lại chúng theo template mới.
Cách này phù hợp với các ứng dụng không thể chạy đồng thời phiên bản cũ và mới một cách an toàn. Tuy nhiên, tính năng vẫn yêu cầu bật feature gate tương ứng.
Khởi tạo Watch Cache ổn định hơn
Kubernetes 1.37 đưa cơ chế khởi tạo Watch Cache có khả năng phục hồi lên trạng thái Stable.
Cơ chế này giúp bảo vệ API server trong quá trình khởi động và khôi phục bằng cách tránh các đợt tăng đột biến lưu lượng truy cập vào etcd. Kubernetes cũng có thể trả về HTTP 429 khi cần giới hạn yêu cầu trong lúc cache được khởi tạo.
Các controller và operator cần xử lý đúng những phản hồi này bằng cơ chế thử lại (retry) và giãn thời gian giữa các lần thử (backoff).
Kết luận
Kubernetes 1.37 mang đến nhiều cải tiến hữu ích về tự động mở rộng, lập lịch, quản lý tài nguyên, bảo mật và độ tin cậy của cluster. HPA hỗ trợ scale về 0 và khả năng hỗ trợ workload AI/ML là những điểm nổi bật, trong khi một số tính năng đã được phát triển trong thời gian dài cuối cùng cũng đạt trạng thái Stable.