
Cách một project sử dụng eBPF thay thế iptables, kube-proxy, sidecar và một phần lớn hệ thống observability.
Vì sao Kubernetes network cần được thiết kế lại?
Kubernetes đưa ra cam kết đơn giản: mỗi pod có một IP riêng và mọi pod đều có thể giao tiếp với nhau mà không cần NAT. CNI (Container Network Interface) chịu trách nhiệm thực hiện điều này. Trong nhiều năm, giải pháp phổ biến là Linux bridge, các veth pair và hàng nghìn quy tắc iptables do kube-proxy quản lý.
Tuy nhiên, các công cụ này được thiết kế cho máy chủ ổn định, không phù hợp với cluster nơi pod chỉ tồn tại trong thời gian ngắn và IP liên tục được tái sử dụng.
iptables xử lý quy tắc tuần tự, khiến việc thêm Service có thể làm tăng độ trễ xử lý gói tin.
Các quy tắc bảo mật dựa trên IP nhanh chóng lỗi thời khi pod được khởi tạo lại ở vị trí khác.
Khi xảy ra sự cố, việc chẩn đoán thường phải dựa vào tcpdump trên các node để bắt gói tin.
Cilium giải quyết các vấn đề này từ gốc bằng cách sử dụng eBPF để chuyển data plane vào chính Linux kernel.
Bốn mô hình traffic mà mọi CNI đều phải xử lý
Trước khi tìm hiểu về Cilium, chúng ta nên xem xét những nhiệm vụ mà bất kỳ CNI nào cũng phải đảm nhận.
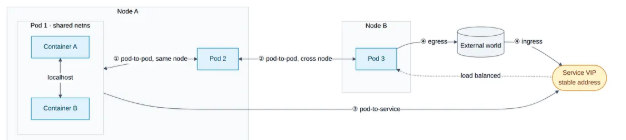
Các container bên trong một pod chia sẻ chung một network namespace và giao tiếp với nhau thông qua localhost. Các pod có thể liên lạc trực tiếp với nhau bằng IP address, ngay cả khi chúng nằm trên các node khác nhau. Các service cung cấp một địa chỉ IP ảo ổn định, đóng vai trò là layer trung gian trước một tập hợp các pod có thể thay đổi linh hoạt. Trong khi đó, cơ chế ingress/egress kết nối cluster với các thành phần bên ngoài. Các giải pháp CNI truyền thống xử lý từng vấn đề này bằng những cơ chế riêng biệt, còn Cilium giải quyết cả 4 vấn đề đó thông qua các eBPF program.
eBPF thay đổi điều gì?
eBPF cho phép nạp các program nhỏ đã được kiểm tra vào kernel và gắn chúng vào các điểm hook như network interface, socket và system call mà không cần viết kernel module hay khởi động lại hệ thống. Bộ kiểm tra của kernel đảm bảo chương trình không làm sập hệ thống hoặc chạy vòng lặp vô hạn. JIT compiler chuyển chương trình thành mã máy gốc.
Điểm cốt lõi là maps. Trạng thái của policy và service được lưu trong các kernel hash table, do agent cập nhật trực tiếp. Khi thêm Service hoặc thay đổi policy, hệ thống chỉ cần cập nhật map thay vì viết lại hàng nghìn quy tắc. Vì vậy, chi phí tra cứu gần như không đổi khi quy mô cluster tăng lên.
Kiến trúc của Cilium
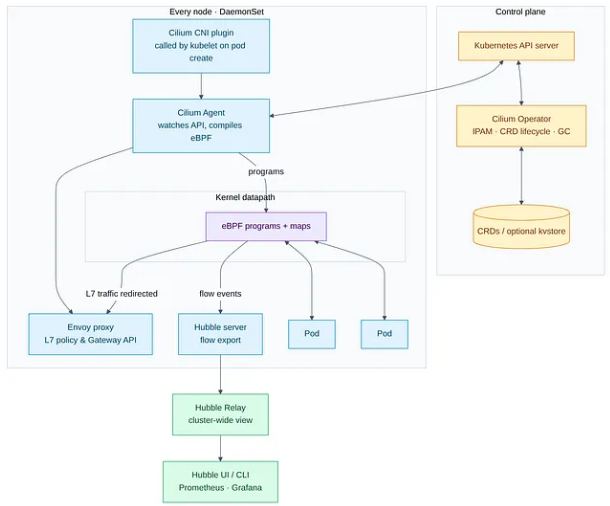
- Cilium Agent chạy trên mỗi node dưới dạng DaemonSet. Agent theo dõi Kubernetes API để phát hiện pod, Service và policy, sau đó biên dịch, nạp các eBPF program tương ứng và đồng bộ các map.
- Cilium CNI Plugin là binary gọn nhẹ được kubelet gọi khi pod khởi chạy. Plugin chuyển công việc cho agent để thiết lập giao diện mạng và IP cho pod.
- Cilium Operator xử lý các tác vụ ở cấp cluster, chỉ thực hiện một lần thay vì trên từng node, như cấp dải IP cho node, quản lý CRD và thu gom các identity không còn sử dụng.
- Envoy được tích hợp trên mỗi node, không phải mỗi pod. Envoy chỉ xử lý lưu lượng cần xử lý ở tầng L7, như policy nhận biết HTTP, định tuyến Gateway API hoặc kết thúc TLS. Các lưu lượng khác được xử lý hoàn toàn bằng eBPF.
- Hubble thu thập sự kiện lưu lượng trực tiếp từ datapath và tổng hợp qua Hubble Relay để cung cấp góc nhìn toàn cluster.
Điều gì xảy ra khi một pod khởi chạy
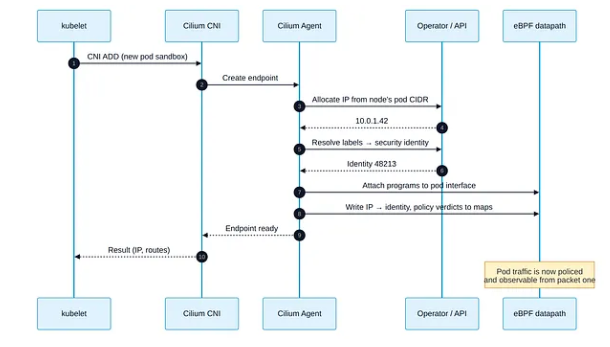
Bước 5 là yếu tố tạo nên sự khác biệt cho Cilium, và nó xứng đáng có một phần riêng.
Bảo mật dựa trên định danh (Identity-based security): ngừng tin tưởng vào địa chỉ IP
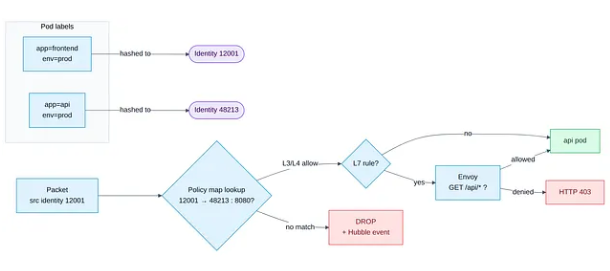
Các network policy truyền thống thường đặt câu hỏi: “Gói tin này có đến từ địa chỉ IP 10.0.1.42 hay không?”. Tuy nhiên, trong môi trường Kubernetes, địa chỉ IP đó có thể thuộc về một workload hoàn toàn khác chỉ sau năm phút. Thay vào đó, Cilium xác định một định danh bảo mật dạng số dựa trên các labels của pod. Mọi pod có cùng label `app=frontend` và `env=prod` sẽ chia sẻ chung một identity, bất kể chúng được triển khai trên node nào hay được gán địa chỉ IP nào.
Thông tin định danh được truyền đi cùng với gói tin (nằm trong phần tunnel header, hoặc được tra cứu thông qua IP-to-identity map trong native routing mode), nhờ đó việc thực thi policy chỉ cần thông qua một thao tác tra cứu duy nhất. Dưới đây là ví dụ về một chính sách có khả năng nhận diện layer 7 (L7-aware policy):
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
name: api-allow-frontend-reads
spec:
endpointSelector:
matchLabels:
app: api
ingress:
- fromEndpoints:
- matchLabels:
app: frontend
toPorts:
- ports:
- port: "8080"
protocol: TCP
rules:
http:
- method: GET
path: "/api/.*"
Frontend có thể đọc dữ liệu từ API, nhưng thao tác DELETE lại trả về lỗi 403 - một yêu cầu mà NetworkPolicy tiêu chuẩn của Kubernetes (vốn chỉ hoạt động ở L4) không thể thực hiện được. Cilium còn hỗ trợ các quy tắc egress dựa trên DNS (toFQDNs), cho phép bạn thiết lập quyền truy cập cho các tên miền như *.stripe.com thay vì phải cố định các dải địa chỉ IP vốn thường xuyên thay đổi.
Thay thế kube-proxy
Đây là lúc mà câu chuyện về hiệu năng trở nên cụ thể.
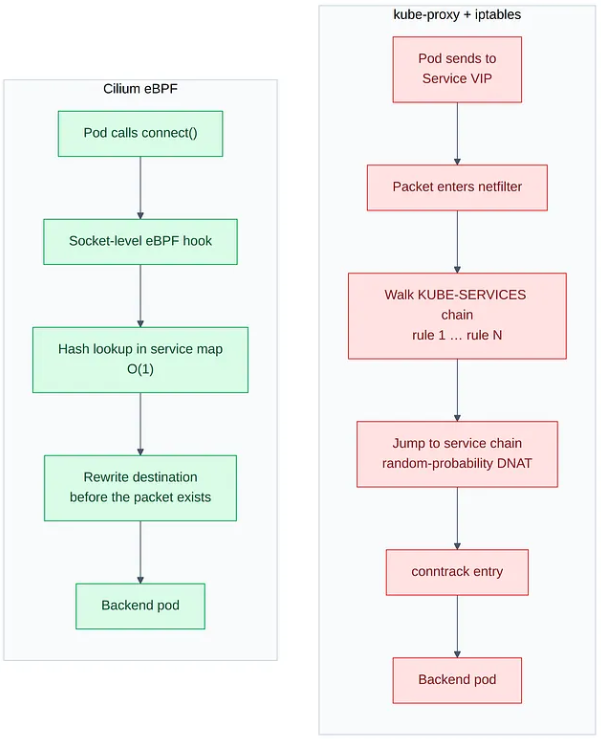
Với iptables, chi phí service lookup tăng lên theo số lượng service, và mỗi lần cập nhật đều viết lại các bộ quy tắc lớn. Cơ chế load balancing cấp socket của Cilium dịch Service VIP thành backend tại thời điểm kết nối(), do đó đối với traffic trong cluster, hoàn toàn không có NAT trên mỗi gói tin. Đối với traffic đến từ bên ngoài, Cilium có thể chạy load balancing ở XDP layer, loại bỏ hoặc chuyển hướng các gói tin trước khi kernel phân bổ memory cho chúng. Cilium cũng hỗ trợ Maglev consistent hashing, giúp backend ổn định khi mở rộng quy mô, và Direct Server Return (DSR), cho phép gói phản hồi đi thẳng về đích mà không cần qua thêm một chặng trung gian.
Kích hoạt tính năng này trên một cluster mới (được tạo mà không có kube-proxy):
cilium install \
--set kubeProxyReplacement=true \
--set k8sServiceHost=
--set k8sServicePort=6443
cilium status --wait
Observability với Hubble
Vì mọi gói tin đều đi qua các eBPF program của Cilium, nên việc ghi lại các event gần như không tiêu tốn thêm tài nguyên. Hubble chuyển đổi các event đó thành các luồng dữ liệu có thể truy vấn, đi kèm với context của Kubernetes - bao gồm các pod name, namespace, label, HTTP path, truy vấn DNS và policy verdict.
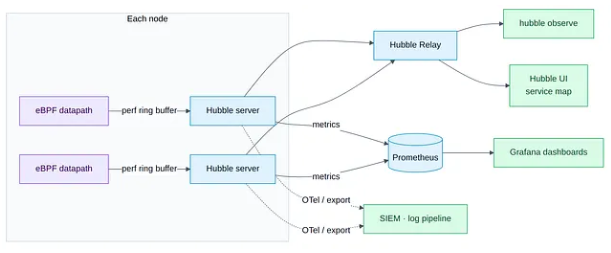
Lệnh để xử lý sự cố kiểu “tại sao A không thể kết nối tới B?” có tính hữu ích rất cao:
cilium hubble enable --ui
hubble observe --namespace prod --verdict DROPPED --follow
Bạn có thể thấy chính xác luồng dữ liệu nào bị loại bỏ, policy nào đã loại bỏ nó, và giữa những identity nào - không cần dùng tcpdump, cũng không cần mất công suy đoán.
Không chỉ là CNI: Nền tảng Cilium hiện đại
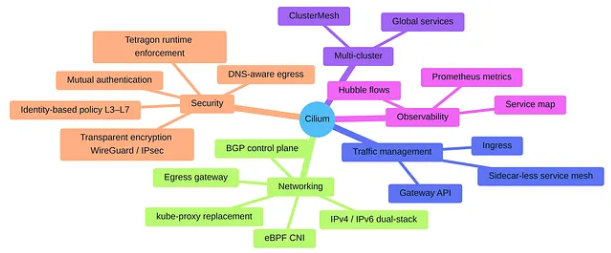
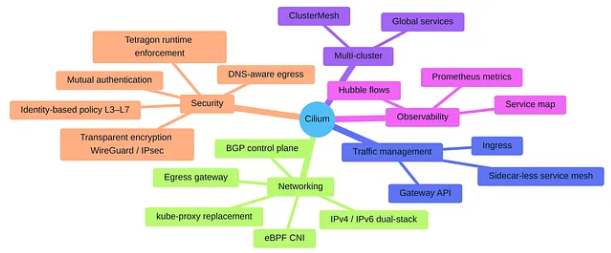
Cilium đã phát triển vượt xa vai trò CNI đơn thuần. Trong các hệ thống hiện nay, Cilium thường thay thế nhiều công cụ riêng biệt.
Service mesh không cần sidecar: Thay vì chèn một container Envoy vào mỗi pod, Cilium xử lý L3/L4 bằng eBPF và chỉ dùng một Envoy chung trên mỗi node cho lưu lượng cần tính năng L7. Cách này hỗ trợ retry, phân chia lưu lượng và các cơ chế bảo mật tương tự mTLS, đồng thời giảm đáng kể chi phí memory và latency.
Gateway API: Cilium cung cấp triển khai Gateway API tuân thủ đặc tả, cho phép định tuyến north-south sử dụng cùng data plane thay vì cần một ingress controller riêng.
Tetragon: Dự án liên quan sử dụng eBPF để bảo mật runtime, cho phép giám sát và chặn việc thực thi tiến trình, truy cập tệp và leo thang đặc quyền ngay ở cấp kernel, đồng thời liên kết sự kiện với các Kubernetes identity tương ứng.
ClusterMesh: Kết nối nhiều cluster thành một mạng thống nhất, dùng chung identity và cung cấp Service trên phạm vi toàn hệ thống.
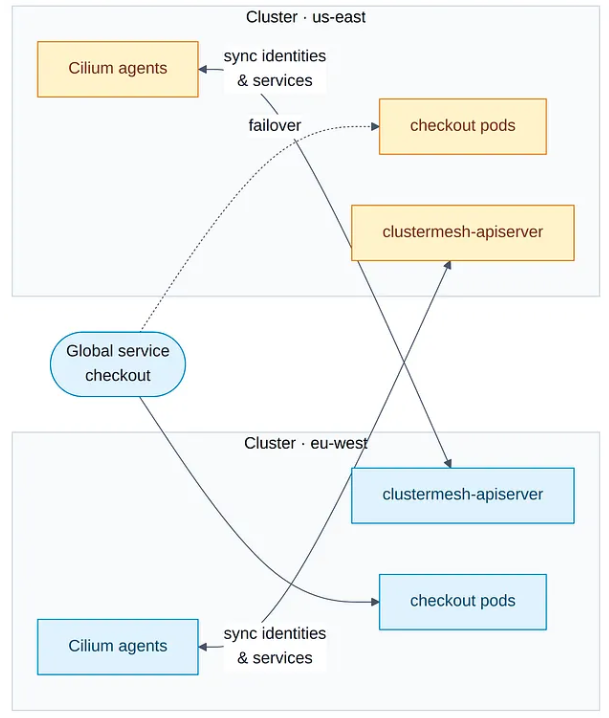
Policy được định nghĩa ở một cluster có thể nhận diện các identity từ cluster khác. Service được đánh dấu là global sẽ tự động chuyển đổi dự phòng giữa các region khi xảy ra sự cố.
Cilium và service mesh dùng sidecar: Khi nào nên chọn giải pháp nào?
Cilium hỗ trợ network L3/L4, policy dựa trên identity, observability và nhiều tính năng L7 mà không cần sidecar.
Service mesh đầy đủ như Istio vẫn có nhiều tính năng L7 chuyên sâu hơn, bao gồm rich traffic policy, phân quyền chi tiết và hệ sinh thái lớn. Chế độ ambient của Istio cũng đã loại bỏ sidecar trên từng pod.
Nhiều team sử dụng cả hai: Cilium làm CNI và data plane, còn service mesh được bổ sung khi thực sự cần kiểm soát L7 nâng cao.
Việc lựa chọn phụ thuộc vào yêu cầu L7:
- Retry và canary: Cilium có thể đã đủ.
- Phân quyền phức tạp theo từng request giữa hàng chục team: Service mesh có thể phù hợp hơn dù kiến trúc phức tạp hơn.
Kết luận
Ý tưởng cốt lõi của Cilium rất đơn giản: xử lý ngay trong kernel, sử dụng identity thay vì IP làm cơ sở nhận diện và ghi nhận hoạt động ngay tại đó.
Cách tiếp cận này thay thế iptables, kube-proxy, phần lớn chức năng của sidecar và nhiều bước trong quy trình gỡ lỗi mạng.
Nếu triển khai cluster mới, nên cân nhắc chọn Cilium làm mặc định và chỉ bổ sung công cụ khác khi Cilium chưa đáp ứng đủ nhu cầu.
Theo Medium