
Khi nói với trợ lý ảo hoặc gọi đến tổng đài tự động, hệ thống cần chuyển lời nói thành dữ liệu để xử lý. ASR đảm nhận bước nhận dạng này, nhưng không tự động hiểu hay giải quyết mọi yêu cầu. Bài viết giải thích ASR hoạt động ra sao, được ứng dụng ở đâu và doanh nghiệp nên đánh giá công nghệ này như thế nào.
Nhận dạng giọng nói tự động (ASR) là gì?
Nhận dạng giọng nói tự động, tiếng Anh là Automatic Speech Recognition (ASR), là công nghệ giúp máy tính nhận tín hiệu âm thanh có lời nói và chuyển nội dung đó thành văn bản. Ví dụ, khi khách hàng nói “Tôi muốn đổi lịch giao hàng sang sáng mai”, hệ thống ASR có thể tạo ra bản chép lời tương ứng để phần mềm tiếp tục xử lý.
Nhận dạng giọng nói tự động (ASR) là công nghệ trí tuệ nhân tạo (AI) chuyển đổi âm thanh nói thành văn bản
ASR thường được gọi là speech-to-text hoặc chuyển giọng nói thành văn bản. Công nghệ này có thể xử lý tệp ghi âm có sẵn hoặc nhận dạng âm thanh trực tiếp khi người dùng đang nói. Với chế độ thời gian thực, hệ thống có thể trả kết quả từng phần trong lúc âm thanh được gửi đến; với chế độ xử lý tệp, kết quả được trả sau khi bản ghi được phân tích.
ASR trả lời câu hỏi “người nói đã nói gì?”. Tự nó không nhất thiết hiểu đầy đủ mục đích của câu nói hoặc thực hiện nghiệp vụ tiếp theo. Trong một quy trình tổng đài AI, chẳng hạn, ASR chuyển lời khách thành văn bản; một thành phần khác có thể xác định khách muốn đổi lịch, tra cứu thông tin rồi phản hồi hoặc chuyển cuộc gọi cho nhân viên.
ASR hoạt động như thế nào?
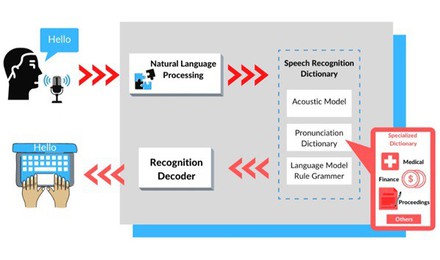
Ở mức khái quát, một quy trình nhận dạng giọng nói thường gồm các bước sau:
- Thu âm thanh: Nhận dữ liệu từ micro, điện thoại, tệp ghi âm hoặc thiết bị khác.
- Chuẩn bị tín hiệu: Hệ thống có thể xử lý nhiễu, chia âm thanh thành đoạn và kiểm tra thông tin như ngôn ngữ, định dạng hay tần số lấy mẫu.
- Nhận dạng lời nói: Mô hình phân tích đặc điểm âm thanh và dự đoán chuỗi từ phù hợp. Thông tin về ngôn ngữ và ngữ cảnh có thể giúp lựa chọn giữa những từ có cách phát âm gần giống nhau.
- Tạo kết quả: Hệ thống xuất văn bản, đôi khi kèm dấu câu, mốc thời gian hoặc độ tin cậy cho một số từ. Những tính năng này tùy vào công nghệ và cấu hình được sử dụng.
Các mô hình ASR hiện đại có thể kết hợp nhiều phần của quy trình trong cùng một mô hình. Vì vậy, sơ đồ trên mô tả các chức năng cần có, không nhất thiết là cấu trúc nội bộ của mọi sản phẩm.
Sau khi có văn bản, ứng dụng có thể chuyển sang bước hiểu ngôn ngữ hoặc xử lý nghiệp vụ. Chẳng hạn, với câu “Tôi muốn đổi lịch lắp đặt sang sáng thứ Sáu”, ASR tạo bản chép lời; hệ thống xử lý ngôn ngữ tự nhiên (NLP) có thể xác định ý định đổi lịch và lấy thông tin thời gian. Việc kiểm tra lịch còn trống và xác nhận thay đổi là bước xử lý riêng.
ASR cũng là một phần trong quy trình hoạt động của Voicebot: hệ thống nhận dạng lời nói, phân tích yêu cầu, xử lý tác vụ rồi phản hồi bằng giọng nói.
ASR khác gì NLP, TTS và nhận diện người nói?
| Công nghệ | Chức năng chính | Ví dụ |
|---|---|---|
| ASR | Chuyển lời nói thành văn bản | “Cho tôi kiểm tra đơn hàng” → văn bản tương ứng |
| NLP/NLU | Phân tích ý nghĩa, ý định hoặc thông tin trong văn bản | Xác định khách muốn tra cứu đơn hàng |
| TTS | Chuyển văn bản thành giọng nói | Đọc câu trả lời thành âm thanh |
| Nhận diện người nói | Xác định hoặc phân biệt người đang nói, tùy hệ thống | Phân biệt các giọng nói trong bản ghi |
Trong hội thoại bằng giọng nói, các công nghệ này có thể được dùng cùng nhau. ASR ghi lại lời khách, NLP/NLU xác định yêu cầu, hệ thống nghiệp vụ tra cứu dữ liệu và TTS đọc câu trả lời.
Nhận dạng giọng nói cũng không đồng nghĩa với sinh trắc học giọng nói. ASR tập trung vào nội dung được nói; sinh trắc học giọng nói tập trung vào đặc điểm giọng của một người để hỗ trợ xác minh danh tính.
ASR được ứng dụng ở đâu?
ASR có thể xuất hiện trong nhiều sản phẩm, từ công cụ ghi âm thành văn bản đến hệ thống giao tiếp bằng giọng nói. Mỗi ứng dụng sẽ cần mức độ chính xác, tốc độ phản hồi và cách xử lý dữ liệu khác nhau.
Tổng đài và chăm sóc khách hàng
ASR có thể chuyển cuộc gọi thành văn bản để hỗ trợ tìm kiếm, tra cứu hoặc đánh giá nội dung hội thoại. Khi kết hợp với các thành phần xử lý khác, hệ thống có thể phân loại yêu cầu và chuyển cuộc gọi đến bộ phận phù hợp. Đây là một phần của quy trình Tổng đài AI inbound, nơi hệ thống tiếp nhận, nhận diện nhu cầu và định tuyến cuộc gọi.
ASR là nền tảng cốt lõi giúp tự động hóa và nâng cao hiệu suất vận hành
Ghi biên bản và tạo phụ đề
Công nghệ này hỗ trợ tạo bản ghi từ cuộc họp, bài giảng, phỏng vấn hoặc nội dung video. Người dùng có thể tìm từ khóa trong văn bản thay vì nghe lại toàn bộ tệp, nhưng bản chép lời vẫn nên được rà soát nếu cần độ chính xác cao.
Nhập liệu bằng giọng nói
Trong ứng dụng di động hoặc phần mềm nghiệp vụ, người dùng có thể đọc nội dung thay vì gõ. Cách này hữu ích khi thao tác bằng giọng nói thuận tiện hơn, nhưng cần kiểm tra kỹ các trường quan trọng như tên, địa chỉ, ngày tháng và mã số.
Điều khiển bằng giọng nói
Trợ lý ảo hoặc thiết bị thông minh có thể dùng ASR để nhận câu lệnh. ASR chuyển câu lệnh thành văn bản; phần xử lý phía sau xác định hành động cần thực hiện.
Yếu tố nào ảnh hưởng đến độ chính xác của ASR?
Độ chính xác của hệ thống ASR (Automatic Speech Recognition) phụ thuộc vào nhiều yếu tố kỹ thuật
Chất lượng nhận dạng không chỉ phụ thuộc vào mô hình. Kết quả còn chịu ảnh hưởng từ dữ liệu âm thanh và cách cấu hình hệ thống.
- Chất lượng âm thanh: Tiếng ồn, âm thanh bị rè, micro đặt xa hoặc nhiều người nói cùng lúc có thể khiến lời nói khó nhận dạng.
- Cách phát âm và tốc độ nói: Giọng vùng miền, nói nhanh, nói nhỏ, ngập ngừng hoặc nói chồng lên nhau có thể làm tăng lỗi.
- Từ ngữ chuyên ngành: Tên riêng, mã sản phẩm, tên thuốc, địa danh và thuật ngữ ít phổ biến dễ bị nhận dạng nhầm nếu không nằm trong vốn từ phù hợp. Một số hệ thống cho phép bổ sung từ hoặc cụm từ gợi ý để cải thiện nhận dạng những trường hợp này.
- Ngôn ngữ và ngữ cảnh: Cần chọn cấu hình phù hợp với ngôn ngữ, biến thể vùng miền và kiểu âm thanh. Một mô hình nhận dạng tốt trong môi trường thu âm rõ chưa chắc cho kết quả tương tự trên bản ghi điện thoại.
- Thông số âm thanh: Định dạng, tần số lấy mẫu và cấu hình nhận dạng cần khớp với dữ liệu thực tế. Hướng dẫn của Google Cloud cũng lưu ý cần khai báo chính xác các thông tin này khi gửi âm thanh tới dịch vụ nhận dạng.
Vì vậy, không nên đánh giá ASR chỉ bằng một bản ghi mẫu rõ tiếng. Hãy thử với âm thanh đại diện cho môi trường sử dụng thật, gồm giọng nói, thuật ngữ và tình huống mà hệ thống sẽ gặp.
Đánh giá ASR bằng cách nào?
Một chỉ số thường dùng để so sánh bản chép lời là Word Error Rate (WER). Công thức tính:
WER = (S + D + I) / N
Trong đó, S là số từ bị thay thế, D là số từ bị bỏ sót, I là số từ được chèn thêm và N là số từ trong bản tham chiếu. WER càng thấp thì bản nhận dạng càng gần với bản tham chiếu trên tập dữ liệu được đánh giá.
WER hữu ích để so sánh các hệ thống trên cùng một bộ âm thanh, nhưng không nên dùng riêng lẻ. Với tổng đài hoặc quy trình bán hàng, một lỗi ở số điện thoại, ngày hẹn, địa chỉ hay mã đơn có thể quan trọng hơn một lỗi ở từ đệm. Doanh nghiệp nên đánh giá thêm:
- Độ chính xác của thông tin quan trọng với nghiệp vụ
- Khả năng xử lý giọng nói và chất lượng âm thanh thực tế
- Độ trễ nếu cần phản hồi ngay trong cuộc gọi
- Tỷ lệ yêu cầu được xử lý đúng hoặc chuyển đến đúng người
- Cách hệ thống xử lý khi không chắc chắn về nội dung
Khi đánh giá tiếng Việt, cần thống nhất cách chuẩn hóa và tách từ giữa bản tham chiếu với kết quả nhận dạng. Nếu không, cách ghi số, dấu câu hoặc từ ghép có thể làm kết quả so sánh thiếu nhất quán.
Doanh nghiệp nên chọn hoặc triển khai ASR ra sao?
Trước tiên, hãy xác định ASR sẽ phục vụ việc gì: chép lời từ tệp ghi âm, tạo phụ đề, nhập liệu bằng giọng nói hay xử lý cuộc gọi trực tiếp. Mỗi trường hợp có yêu cầu khác nhau về độ trễ, định dạng âm thanh và cách sử dụng văn bản đầu ra.
Tiếp theo, thử nghiệm trên dữ liệu đại diện cho môi trường thật. Chuẩn bị âm thanh có tiếng ồn, giọng vùng miền, cách nói tự nhiên và các từ quan trọng của ngành. So sánh bản nhận dạng với bản chép lời đã được kiểm tra, đồng thời đánh giá WER và độ chính xác của các trường nghiệp vụ.
Trải nghiệm cho khách hàng gọi thử thực tế
Nếu đang chọn giải pháp cho tổng đài, hãy kiểm tra thêm khả năng xử lý tiếng Việt, tích hợp hệ thống và cách chuyển tiếp khi AI chưa hiểu đúng. Có thể tham khảo 9 tiêu chí lựa chọn tổng đài AI cho doanh nghiệp để xây dựng bộ tiêu chí đánh giá.
Cuối cùng, xem xét khả năng tích hợp, chi phí vận hành và cách dữ liệu âm thanh, bản chép lời được lưu trữ, truy cập và xử lý. Với thông tin có ảnh hưởng trực tiếp đến khách hàng, nên có bước xác nhận hoặc cơ chế chuyển nhân viên khi hệ thống không nhận dạng đủ chắc chắn.
Câu hỏi thường gặp về ASR
Khi tìm hiểu ASR, người đọc thường muốn biết công nghệ này có thể làm gì và đâu là giới hạn của nó. Các câu trả lời dưới đây giúp phân biệt ASR với những công nghệ xử lý giọng nói thường được dùng cùng nhau.
ASR có phải là chuyển giọng nói thành văn bản không?
Có. ASR là công nghệ nhận dạng lời nói và tạo văn bản từ âm thanh; “speech-to-text” là cách gọi phổ biến cho chức năng này.
ASR có hiểu khách hàng muốn gì không?
Không nhất thiết. ASR tạo bản chép lời. Việc xác định ý định, tra cứu dữ liệu hoặc thực hiện yêu cầu thường cần thêm NLP/NLU và các thành phần nghiệp vụ.
ASR có thể nhận dạng giọng nói theo thời gian thực không?
Có. Một số hệ thống hỗ trợ nhận dạng luồng âm thanh và trả kết quả trong khi người dùng đang nói. Khả năng này phụ thuộc vào sản phẩm, cấu hình và độ trễ chấp nhận được.
ASR có nhận diện được người đang nói không?
ASR tập trung vào nội dung lời nói. Một số hệ thống có thể phân tách các lượt nói theo người nói, nhưng việc đó không tự động đồng nghĩa với xác định danh tính của họ.
Làm sao biết ASR có phù hợp với doanh nghiệp?
Hãy thử trên âm thanh, thuật ngữ và nghiệp vụ thực tế. Ngoài WER, cần kiểm tra các thông tin quan trọng, tốc độ phản hồi, khả năng tích hợp và cách xử lý khi hệ thống chưa chắc chắn.
Tổng kết
ASR chuyển lời nói thành văn bản để ứng dụng hoặc doanh nghiệp có thể tìm kiếm và xử lý nội dung âm thanh. Công nghệ này là một phần của quy trình giọng nói; để hiểu yêu cầu và thực hiện nghiệp vụ, thường cần kết hợp thêm NLP/NLU, dữ liệu và quy tắc xử lý. Khi lựa chọn ASR, hãy thử trên dữ liệu thực tế và đánh giá cả độ chính xác lẫn kết quả công việc mà hệ thống cần hoàn thành.
Nếu doanh nghiệp muốn tự động tiếp nhận, phân luồng và xử lý cuộc gọi, ASR thường chỉ là một phần trong giải pháp tổng thể. Tổng đài AI Bizfly Cloud giới thiệu các chức năng tiếp nhận và phân luồng cuộc gọi, chuyển nhân viên kèm ngữ cảnh, cùng chuyển giọng nói thành văn bản trong quy trình QA/QC. Nếu mục tiêu chính là phân tích và chấm điểm nội dung cuộc gọi, có thể tìm hiểu thêm Bizfly Cloud QC Assistant. Doanh nghiệp nên đối chiếu các chức năng với tình huống sử dụng và quy trình thực tế của mình.