
Apache Phoenix: Các Global Secondary Index với Consistency có thể điều chỉnh
Apache Phoenix đã phát triển bổ sung một số tính năng cho HBase nhằm nâng cao năng lực của distributed database này.
Apache Phoenix cung cấp giao diện SQL mã nguồn mở trên nền tảng Apache HBase, kết hợp sức mạnh của horizontal scaling và sharding từ hệ thống NoSQL với sự đơn giản của SQL, để phục vụ cho các thao tác OLTP (xử lý giao dịch trực tuyến) với low-latency và high-throughput trên tập data quy mô petabyte.
Phoenix bổ sung cho HBase các tính năng như Global Secondary Indexes - GSI, các thao tác update Atomic và Conditional, Change Data Capture - CDC, các view có thể update được, cùng khả năng hỗ trợ multi-tenancy trên các table, index, và view. Ngoài ra, Phoenix còn hỗ trợ cơ chế đẩy logic thực thi về phía máy chủ (server-side push-down) để xử lý các thao tác kết hợp (join) và nhóm (grouping) phức tạp trong các truy vấn OLAP (xử lý phân tích trực tuyến).
Các GSI trong Phoenix được vận hành dựa trên các HBase table riêng biệt. Với mỗi tập data gồm N index, hệ thống sẽ duy trì tổng cộng (N + 1) HBase table để phục vụ các thao tác đọc và ghi: bao gồm N index table và một data table gốc. Chế độ nhất quán (consistency mode) của index sẽ quyết định thời điểm chính xác mà dữ liệu được ghi vào các index đó trở nên khả dụng cho các thao tác đọc. Trước hết, hãy cùng tìm hiểu về khái niệm nhất quán dữ liệu khi đọc (read consistency) trong database.
Đối với các distributed database, đây là mô hình nhất quán cấp ở high-level:
Các mô hình nhất quán (Consistency Models) trong cơ sở dữ liệu phân tán
- Eventual Consistency (Nhất quán cuối cùng): Dữ liệu sẽ nhất quán sau một khoảng thời gian, nhưng không nhất thiết ngay sau khi ghi.
- Read-your-writes: Người dùng luôn thấy các thay đổi do chính mình ghi, nhưng có thể chưa thấy ngay các thay đổi từ người khác.
- Causal Consistency (Nhất quán nhân quả): Nếu A dẫn đến B (ví dụ B là phản hồi của A), mọi người đều thấy A trước B.
- Linearizability (Tính tuyến tính hóa): Tất cả client thấy các thao tác theo cùng một thứ tự tổng thể, phù hợp với thứ tự hoàn tất thực tế. Phù hợp với thao tác đọc một key khi không chấp nhận dữ liệu cũ.
- Serializability (Tính tuần tự hóa): Các transaction đồng thời cho kết quả tương đương với việc thực thi tuần tự theo một thứ tự nào đó. Áp dụng cho transaction nhiều key cần tránh trạng thái dữ liệu chưa hoàn chỉnh; thường dùng MVCC, locks hoặc Optimistic Concurrency Control.
- External Consistency / Strict Serializability (Nhất quán bên ngoài / Tuần tự hóa nghiêm ngặt): Kết hợp serializability và linearizability, bảo đảm transaction được sắp xếp theo thứ tự thời gian thực. Thường cần đồng hồ được đồng bộ hoặc cơ chế phối hợp tốn kém.
Đối với HBase và Phoenix, tính nhất quán mạnh (strong consistency) được hiểu là serializability. Theo mặc định, các GSI được Phoenix hỗ trợ đều có tính nhất quán mạnh; nghĩa là, ngay khi thao tác ghi vào bảng dữ liệu hoàn tất, reader được đảm bảo sẽ truy xuất được dữ liệu đã cập nhật từ các GSI tương ứng.
Phoenix triển khai các GSI có tính nhất quán mạnh thông qua cơ chế cam kết hai giai đoạn (two-phase commit) và sửa lỗi khi đọc (read-repair). Mỗi datatable - dù có hay không có các index - đều được gắn một coprocessor có tên là `IndexRegionObserver` vào tất cả các region của bảng đó. Thông qua các hook `preBatchMutate()` và `postBatchMutateIndispensably()` của coprocessor, các thay đổi (mutation) đối với index table sẽ được tạo và thực thi dưới dạng các lệnh gọi RPC.
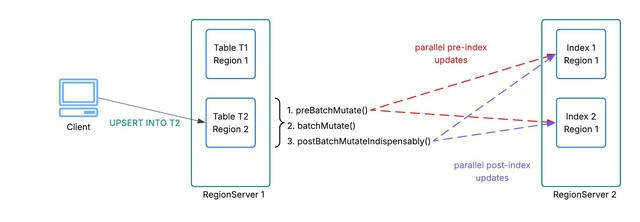
Bên cạnh các GSI có tính nhất quán mạnh, Phoenix hiện còn triển khai các GSI có tính nhất quán cuối cùng (eventually consistent GSI). Cách này giúp phạm vi ứng dụng rộng hơn - bao gồm các ứng dụng đòi hỏi khả năng mở rộng cao, latency thấp và throughput lớn - đồng thời đảm bảo độ trễ ghi dữ liệu ổn định và có thể dự đoán trước, bất kể số lượng GSI được tạo trên datatable là bao nhiêu.
Một số ưu điểm khi sử dụng GSI có tính nhất quán cuối cùng bao gồm:
- Tính sẵn sàng cao cho các thao tác ghi vào data table.
- Độ trễ cực hạn (tail latency) của các thao tác ghi vào bảng dữ liệu ổn định và dễ dự đoán hơn.
- Cải thiện write throughput cho cả data table lẫn các index.
Phoenix cung cấp hai phương thức để triển khai GSI có tính nhất quán cuối cùng thông qua các CDC (Change Data Capture). Các thao tác ghi vào CDC luôn duy trì tính nhất quán mạnh.
Phương pháp 1: CDC Index với các thay đổi chỉ mục được tuần tự hóa (serialized)
Trong phương pháp này, `IndexRegionObserver` trên datatable sẽ tạo ra tất cả các index mutations - áp dụng cho cả các GSI có strong consistent lẫn eventually consistent - sau khi đọc trạng thái hiện tại của row trong datatable. Đối với mỗi row update trong datatable, hệ thống sẽ tuần tự hóa các index mutation có tính nhất quán cuối cùng, kết hợp chúng thành một document định dạng proto duy nhất, rồi ghi document đó dưới dạng một ô (cell) mới trên CDC index row.
Bước này áp dụng cho cả các hook trước và sau khi cập nhật. Trong giai đoạn trước khi update index, document proto chứa tất cả các eventually consistent index mutation dưới dạng các row update chưa được xác thực; và sau đó, ở giai đoạn sau khi update index, thì các cập nhật đã được xác thực.
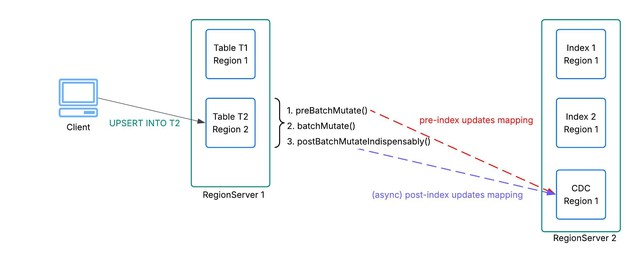
Mỗi vùng data table chạy một consumer CDC đơn luồng với mục đích thực thi các eventually consistent index mutation RPC trong nền. Điều này cho phép mỗi CDC consumer chỉ quét các bản record thay đổi cho vùng hoặc phân vùng đó. CDC consumer quét CDC index để truy xuất các index mutation dưới dạng proto document cho row được chỉ định, giải mã và thực thi chúng dưới dạng RPC. Để cải thiện write throughput của các thao tác ghi GSI, nó sử dụng batch size có thể cấu hình được để thực thi một số eventually consistent GSI mutation bằng một lệnh RPC network call duy nhất.
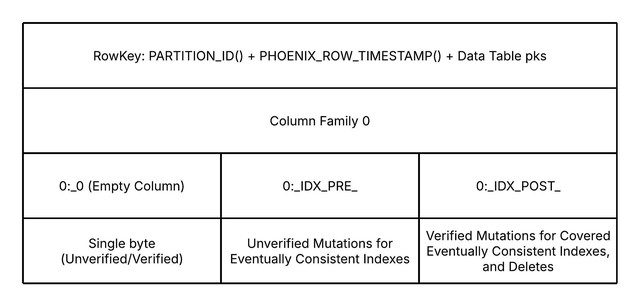
Phương pháp này được tối ưu hóa cho các thao tác đọc (read I/O). CDC consumer không cần phải quét các row trong data table tương ứng với các row trong CDC index. Tuy nhiên, phương pháp này đòi hỏi thêm các thao tác ghi (write I/O) trên CDC index.
Phương pháp 2: CDC dưới dạng uncovered index gọn nhẹ
Trong phương pháp này, CDC index chỉ được sử dụng như một uncovered index, với một cột duy nhất là giá trị cột rỗng được biểu diễn bằng một byte chưa được xác thực. Row key của index vẫn giống phương pháp 1: PARTITION_ID() + PHOENIX_ROW_TIMESTAMP() + data table primary keys.
Vì CDC index chỉ có một cell với giá trị một byte, thao tác ghi vào bảng dữ liệu nhẹ hơn đáng kể so với phương pháp 1. Ngoài ra, phương pháp này chỉ cần thực hiện giai đoạn pre-index update để cập nhật CDC index.
Việc tạo các mutation cho GSI nhất quán cuối cùng đòi hỏi pre-image và post-image của mỗi lần cập nhật data table. Để tạo các image này, phương pháp phải thực hiện raw scan trên data table trong một khoảng thời gian xác định.
Do đó, phương pháp này tối ưu write I/O nhưng phải đánh đổi bằng read I/O bổ sung trên bảng dữ liệu.
Phương pháp này được bật mặc định khi cấu hình phoenix.index.cdc.mutation.serialize có giá trị false. Đặt giá trị thành true để bật phương pháp 1.
Vòng đời CDC Consumer: Quan hệ tổ tiên – hậu duệ (Ancestor/Descendant)
Giai đoạn khởi động (Startup Phase)
Khi một HBase region được mở, coprocessor IndexRegionObserver sẽ tạo một worker IndexCDCConsumer nếu bảng dữ liệu có các index nhất quán cuối cùng (eventually consistent indexes).
Xử lý hoàn tất các Parent Region
Khi một region bị tách (split) hoặc nhiều region được hợp nhất (merge), consumer gắn với các parent region đang split hoặc merge sẽ ngừng xử lý change logs. Consumer của các child region phải tiếp tục xử lý từ vị trí mà consumer của parent đã dừng lại.
Sử dụng thuật toán depth-first search (DFS) để xử lý các ancestor region chưa được xử lý hoàn tất trước khi xử lý các parent region trực tiếp.
Tiếp tục hoặc khởi động Region/Partition hiện tại
Kiểm tra xem SYSTEM.IDX_CDC_TRACKER có chứa timestamp được xử lý gần nhất của region hiện tại hay không.
Nếu có, region đã được chuyển từ server này sang server khác. Tiếp tục xử lý change logs từ timestamp đó. Nếu không, bắt đầu xử lý từ đầu.
Xử lý các bản ghi CDC index theo kích thước batch có thể cấu hình:
Mẫu truy vấn:
SELECT /*+ CDC_INCLUDE(DATA_ROW_STATE) */ PHOENIX_ROW_TIMESTAMP(), "CDC JSON" FROM
Cập nhật index theo batch:
Thực thi BatchMutation trên từng GSI nhất quán cuối cùng, giúp tăng thông lượng ghi index bất kể kích thước ghi ban đầu từ client.
Ví dụ: ngay cả khi ứng dụng client cập nhật 10 hàng trong bảng dữ liệu bằng một RPC call, batch size mặc định là 500 cho phép CDC consumer cập nhật tối đa 500 hàng cho mỗi GSI nhất quán cuối cùng trong một RPC call, qua đó tăng thông lượng ghi của các GSI.
Ví dụ về quan hệ Ancestor–Descendant khi phát lại Change Records
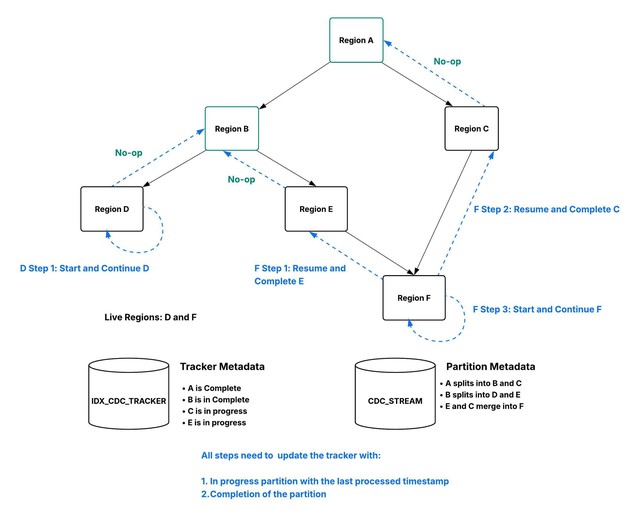
Region A được tách thành B và C.
Region B được tách thành D và E.
Region E và C được hợp nhất thành F.
Region A đã được xử lý hoàn tất.
Region B đã được xử lý hoàn tất.
Region C đang được xử lý.
Region E đang được xử lý.
Các region hiện tại đang hoạt động: D và F.